
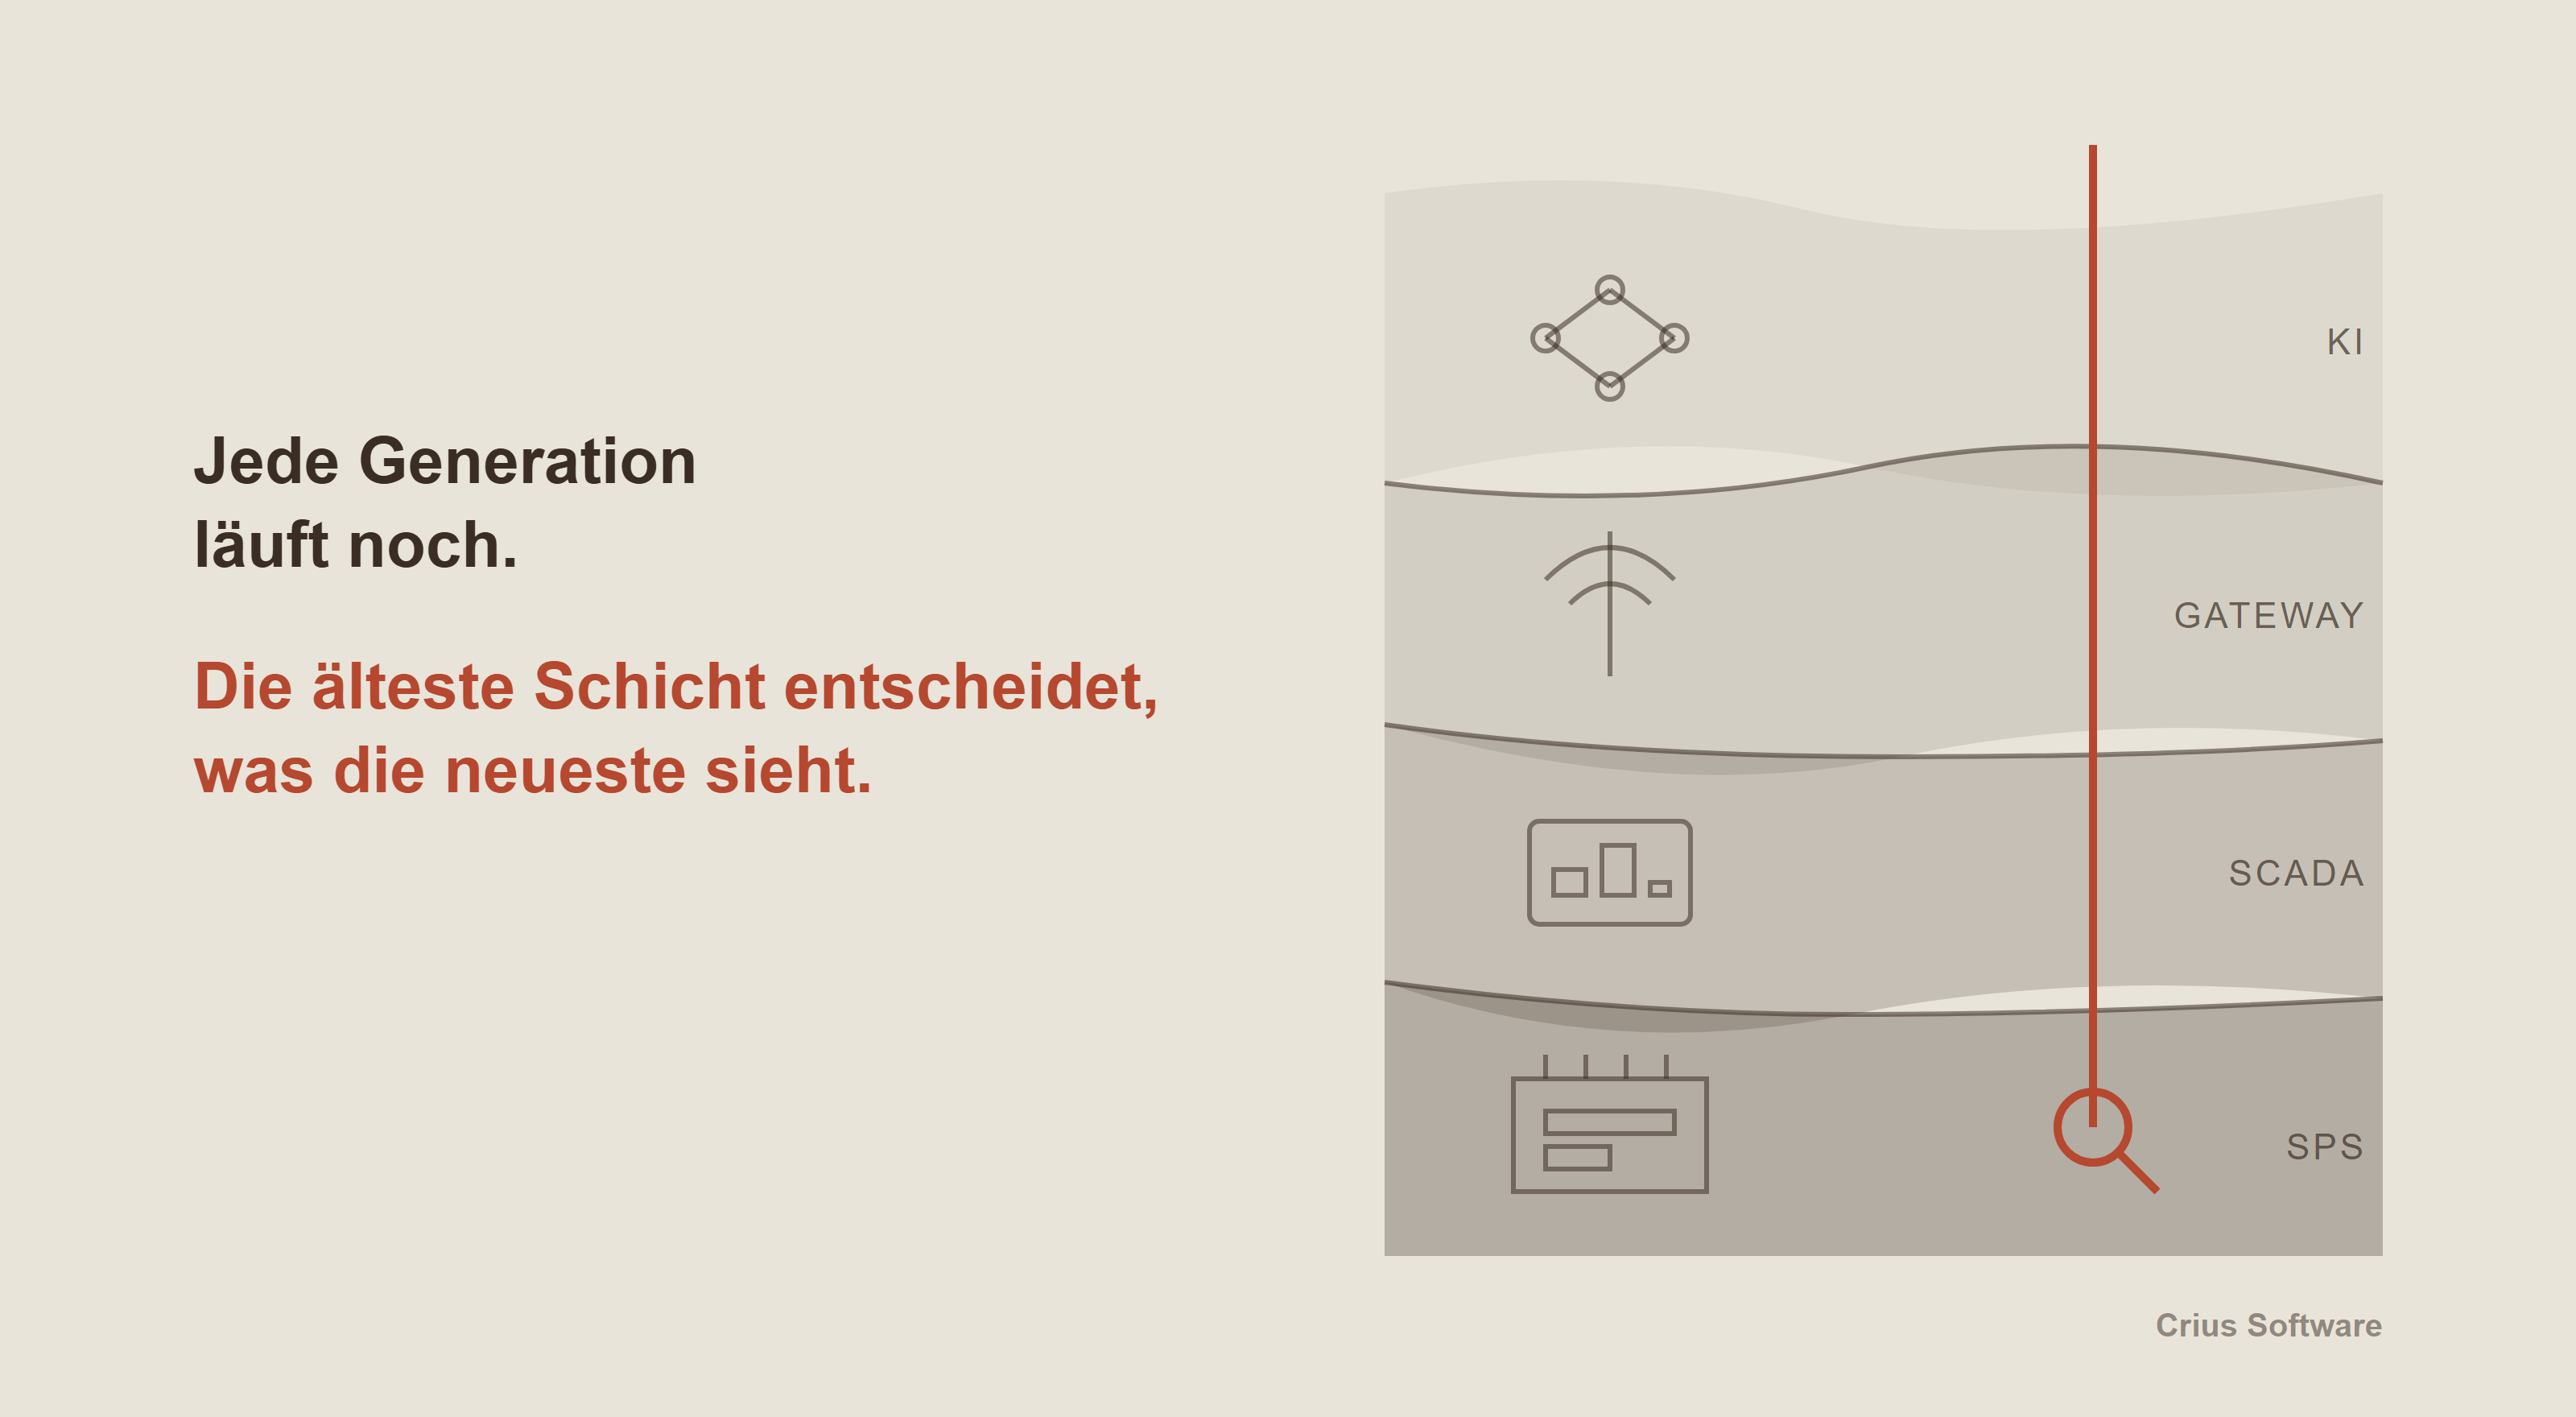
Öffnen Sie den Schaltschrank in fast jedem mittelständischen Werk, und Sie sehen Automatisierungsgeschichte vor sich liegen — nicht hinter sich. Eine deterministische Steuerung aus einer Konstruktionslinie, die bis 1968 zurückreicht, sitzt neben einem Gateway, das vor eineinhalb Jahren installiert wurde. Eine Klemmenverdrahtung, die ein Integrator gezeichnet hat, der längst in Rente ist, legt bis heute fest, was jedes Tag flussabwärts bedeuten darf. Irgendwo im Serverraum verwirft ein Historian gerade in aller Stille den größten Teil des Rohsignals, das er empfängt — absichtlich, weil vor Jahren jemand entschieden hat, dass Speicherplatz wichtiger ist als Signaltextur.
Nichts davon ist Versagen. Es ist Ablagerung. Und genau deshalb ist die gängige Geschichte der industriellen Automatisierung — eine ordentliche fünfstufige Leiter von der speicherprogrammierbaren Steuerung bis zur autonomen Fabrik — eine Geschichte, die Anbieter erzählen, um die nächste Stufe zu verkaufen. Keine Beschreibung irgendeines Werks, das wir je betreten haben.
Hier ist die ehrliche Version: was jede Automatisierungsgeneration tatsächlich hinterlassen hat, warum es bis heute tragend ist, und was das für die KI- und IoT-Initiative bedeutet, die Sie gerade darauf aufsetzen wollen.
Industrielle Realität: Eine Fabrik ist Sediment, keine Treppe
Gehen Sie die Halle mit einem OT-Ingenieur ab statt mit einer Folienpräsentation, und die Leiter-Metapher hält nicht mehr stand. Die Scan-Zyklus-Logik, die eine Presse steuert, ist kein Relikt, das auf Modernisierung wartet — sie leistet exakt die Arbeit, für die sie gebaut wurde, mit einer Determinismus-Güte, die neuere Schichten nicht erreichen sollen. Der SCADA-Historian, dessen Konfigurationsmaske seit Jahren niemand mehr geöffnet hat, ist ebenfalls kein toter Ballast — er ist der einzige Ort, an dem je festgelegt wurde, was jeder Tag-Name bedeutet, und jedes Dashboard, jede MES-Integration und jeder KI-Pilot seither hat diese Namensentscheidungen stillschweigend geerbt.
Was Sie vor sich haben, ist keine Treppe mit einer obersten Stufe namens „autonom“. Es ist Sediment: Jede Schicht wurde mit der Technik und der Wirtschaftlichkeit ihrer Zeit abgelegt, von der darüberliegenden Schicht verdichtet, und ist noch immer strukturell präsent und noch immer in Betrieb. Eine Steuerung ist nicht „Phase 1“. Sie ist der deterministische Boden, auf dem alles andere steht. Ein Historian ist nicht „Phase 2, abgelöst“. Er ist das Schema, das jedes spätere System entweder respektiert oder stillschweigend beschädigt.
Die praktische Konsequenz: „Wie reif ist unsere Automatisierung“ ist die falsche Frage. Sie unterstellt eine einzelne Kennzahl auf einer einzelnen Leiter. Die Frage, die tatsächlich vorhersagt, ob Ihre nächste Initiative funktioniert, ist enger gefasst und weit besser testbar: Wenn sich ein Signal an der Maschine ändert — wie weit reist es, durch wie viele undokumentierte Übersetzungen, an wie vielen Menschen vorbei, die man anrufen muss, damit sie es erklären —, bevor ein System oder ein Mensch flussabwärts handeln kann, ohne zu raten. Wir nennen diese Distanz Adressierbarkeit, und sie ist der rote Faden für alles, was in diesem Artikel folgt.
Warum das Problem strukturell entsteht
Speicherprogrammierbare Steuerungen entstanden im späten Jahrzehnt der 1960er-Jahre, um Relaisschrank-Logik an Automobil-Fertigungsstraßen abzulösen, und die Konstruktionsvorgabe hat sich seither nicht geändert: einen festen Scan-Zyklus deterministisch ausführen, ohne Toleranz für einen ausgefallenen Zyklus nur weil ein Netzwerkpaket zu spät kam. Das ist keine Beschränkung, über die die Automatisierung „hinausgewachsen“ wäre, sondern eine physikalische Anforderung geschlossener Regelkreise in Bewegungs- und Sicherheitssteuerung — und der Grund, warum die Steuerungsebene bis heute überwiegend auf Protokollen läuft, die für Determinismus über ein vertrauenswürdiges, lokales Segment gebaut wurden, nicht für Offenheit. Das Modbus-Protokoll etwa ist älter als die kommerzielle Ethernet-Standardisierung und wurde genau um diesen Kompromiss herum gebaut: einfach, schnell und blind gegenüber allem außerhalb der eigenen Leitung.
SCADA-Systeme kamen, um ein anderes Problem zu lösen: einem Bediener Sichtbarkeit über viele Steuerungen hinweg zu geben. Sie waren erfolgreich — und schufen dabei eine Abhängigkeit, die niemand eingeplant hatte. Jedes Tag in einem SCADA-Historian trägt einen Namen, den ein Integrator bei der Inbetriebnahme vergeben hat — oft unter Termindruck, selten mit einem Auftrag zur Datenführung, nie mit der heutigen KI-Initiative im Kopf. Dieses Namensschema wird zufällig zum Tag-Namensraum des Werks, und jedes später gebaute System hält sich entweder daran oder baut eine eigene Übersetzungsschicht darum herum. Zwanzig Jahre später erinnert sich niemand mehr, dass es eine Entscheidung war — es liest sich wie die angeborene Fachsprache des Werks.
Historians trafen eine zweite, folgenreichere Entscheidung: Deadband-Kompression. Jede Rohprobe jedes Sensors zu speichern war über Jahrzehnte unwirtschaftlich, also wurden Historians so gebaut, dass sie Messwerte verwerfen, die eine konfigurierte Schwelle nicht überschritten haben. Das war der richtige Kompromiss für seine Zeit — Speicher und Bandbreite waren teuer, und ein Trendchart braucht nicht jede Probe. Aber es bedeutet, dass die Textur, die ein Zustandsüberwachungs- oder Prognosemodell heute braucht — die feine Drift vor einer überschrittenen Schwelle —, per Konstruktion verworfen wurde, Jahre bevor jemand daran dachte, Modelle auf diesen Daten zu trainieren. Aus einem Historian lässt sich nicht wiedergewinnen, was er genau dafür gebaut wurde zu verwerfen.
Transportprotokolle lösten ein engeres Problem, als man ihnen zuschreibt: Bytes zuverlässig von einem Punkt zum anderen zu bewegen. OPC UA, von der OPC Foundation als plattformunabhängiger Nachfolger der älteren, Windows-COM-basierten OPC-Classic-Spezifikationen eingeführt, löste Transport und typisierte Datenmodellierung — nicht die semantische Einigung zwischen zwei Integratoren, die denselben physischen Sensor unterschiedlich benannt haben. Dieses letzte Problem — was ein Signal bedeutet, nicht wie es sich bewegt — ist bei den meisten Pilotprojekten bis heute manuelle Abstimmung, und es skaliert nicht mit der Maschinenzahl. Es skaliert mit der Zahl der Menschen, die sich in einem Raum auf einen Namen einigen müssen.
Zusammengenommen erklärt das, warum „warum hat sich die Fabrik nicht längst selbst automatisiert“ der falsche Rahmen ist. Jede Schicht hat ein reales Problem gelöst, mit den Werkzeugen und der Wirtschaftlichkeit ihres Moments, und jede Lösung wurde zur Randbedingung, um die die nächste Schicht herumbauen musste. Der folgende Architektur-Tiefenblick behandelt diese Realität, statt sie wegzudefinieren.
Architektur-Tiefenblick
Der moderne Industrie-Stack lässt sich sinnvoll in drei operative Schichten beschreiben, und die ehrliche Version jeder Schicht schließt ein, was sie aus dem darunterliegenden Sediment geerbt hat.
Edge-Schicht. Echtzeit-Datenerfassung und Vorverarbeitung an der Maschine. Hier lebt die deterministische Steuerungslogik, und Protokollvielfalt ist unvermeidbar — die Edge spricht, was der installierte Bestand an Steuerungen und Antrieben spricht, nicht das, was ein Diagramm sich wünscht. Reiner Lesezugriff zählt über Bequemlichkeit hinaus: Ein Schreibpfad in die Steuerungsebene ist eine Sicherheits- und Haftungsfläche, und die meisten Werksdaten-Initiativen haben keinen legitimen Grund, ihn anzufassen. Die Kompromisse zwischen den hier tatsächlich laufenden Protokollen — und das Muster, sie sauber zu übersetzen statt jedes Gerät einzeln zu bekämpfen — sind dargestellt in MQTT, OPC UA oder Modbus? Der Architekten-Leitfaden für Industrieprotokolle 2026, einschließlich des fünfstufigen Musters vom Gerät bis zum Konsumenten.
Plattformschicht. Zentralisierte Strukturierung, Kontextualisierung und Orchestrierung — die Schicht, die ein Roh-Tag nimmt und Auftrag, Schicht, Charge und Instandhaltungskontext anfügt, wodurch aus einer Zahl eine operative Tatsache wird. Hier wird das Vererbungsproblem des Tag-Namensraums entweder einmal, zentral gelöst — oder von jedem nachgelagerten Konsumenten schlecht neu gelöst. Die siebenstufige Behandlung dieses Rückgrats ist Gegenstand eines eigenen Beitrags: Der Smart-Factory-Datenblueprint.
Unternehmensschicht. Geschäftsintegration — ERP, MES, Qualitätssysteme und die Entscheidungsoberflächen, die ein Werkleiter oder ein Vorstand liest. Das ehrliche Fehlermuster ist nicht ein Mangel an Dashboards; die meisten geprüften Werke haben mehr Dashboards, als je jemand liest. Es fehlt der Pfad von „ein Dashboard zeigt eine Abweichung“ zu „jemand ergreift eine konkrete, zurechenbare Maßnahme“. Eine Schicht, die nur anzeigt, ist keine Architekturentscheidung — sie ist ein teures Fenster. Die Verschiebung von passiver Anzeige zu einem geführten Entscheidungspfad, und schließlich zu einer agentischen Schicht, die Maßnahmen vorschlagen oder innerhalb von Leitplanken ausführen kann, ist das Argument von Jenseits des Dashboards: Warum 2026 das Jahr der agentischen KI und der Unified Namespace wird.
Der Grund, die drei Schichten so zu zeichnen statt als sequenzielle Reifephasen: Ein Werk ist meist in der einen stark und in der anderen schwach — exzellenter Lesezugriff an der Edge, aber eine Plattformschicht, die ohne Telefonanruf nicht beantworten kann, aus welcher Charge ein Teil stammt. Architekturarbeit heißt, die tatsächliche Engstelle zu diagnostizieren — nicht eine Leiter zu unterstellen, die das Werk vielleicht längst in anderer Reihenfolge erklommen hat.
Warum die meisten IIoT-Initiativen nicht skalieren
Das Fehlermuster ist konsistent genug, um ihm einen Namen zu geben: Der Pilot läuft sauber auf einer Maschine, und das Projekt stirbt still zwischen Maschine drei und Maschine dreißig. Nicht durch einen dramatischen Ausfall, sondern durch eine Ansammlung kleiner, struktureller Reibungen, die ein Ein-Maschinen-Pilot nie zutage fördert. Wir nennen das Maschine-eins-Versagen; die Mechanik, warum globale Rollouts genau dort ins Stocken geraten, ist beschrieben in Das Ende des Pilotphasen-Fegefeuers: Warum globale Industrie-Rollouts an Maschine eins scheitern.
Drei dieser Reibungen führen direkt auf das Sediment-Argument zurück, nicht auf etwas IoT-Spezifisches.
Tag-Namensraum-Drift. Die Tags von Maschine eins wurden von demjenigen benannt, der sie konfiguriert hat, nach der Konvention, die vor Ort gerade naheliegend war. Maschine zwei, in Betrieb genommen von einem anderen Integrator oder einer anderen Ära desselben Hausstils, benennt dieselbe physische Messgröße anders. Ein Pilot, der auf der Konvention von Maschine eins aufbaut, kodiert eine Annahme fest, die Maschine zwei still verletzt. Niemand bemerkt es, bis das Dashboard von Maschine zwei Unsinn zeigt — und dann ist die Abstimmung ein manuelles Projekt, keine Konfigurationsänderung mehr.
Gateway-Wildwuchs. Jede neue Maschine, die das native Protokoll der Plattform nicht spricht, bekommt ihr eigenes Punkt-zu-Punkt-Gateway, konfiguriert von wem auch immer gerade verfügbar war. Die Zuständigkeit dafür — wer es patcht, wer alarmiert wird, wenn es still aufhört, Daten weiterzuleiten — ist selten fest zugewiesen. Ein Jahr später kann ein Werk ein gutes Dutzend Gateways ohne gemeinsames Betriebsmodell haben, jedes ein Einzelpunkt-Ausfallrisiko, das niemand beobachtet.
Deadband- und Abtastraten-Mismatch. Das Historian-Sediment taucht hier wieder auf. Ein Pilot beweist seinen Wert mit hochauflösenden, unkomprimierten Daten von einem eigens installierten Sensor. Skalierung bedeutet, dieselbe Signalklasse aus dem vorhandenen Historian zu ziehen — mit der Auflösung, die jahrzehntealte Kompressionseinstellungen übriggelassen haben. Das Modell, das im Pilot funktionierte, verschlechtert sich auf eine Weise, die schwer zu diagnostizieren ist, weil die Daten oberflächlich noch wie Daten aussehen.
Keine dieser drei Reibungen ist exotisch. Sie sind die direkte, vorhersehbare Folge davon, auf Sediment zu bauen, ohne vorher zu kartieren, was jede Schicht tatsächlich enthält. Über Maschine eins hinaus zu skalieren ist eine Architekturdisziplin, kein Problem der Ausrollgeschwindigkeit — weshalb „schneller ausrollen“ meist die falsche Antwort auf einen ins Stocken geratenen Rollout ist.
Governance, Sicherheit & EU-Compliance
Die Governance-Frage, die auf der Architekturebene am meisten zählt, ist eng gefasst: Wer oder was darf in die Steuerungsebene schreiben, und lässt sich das im Nachhinein beweisen? Reiner Lesezugriff an der Edge entfernt eine ganze Kategorie von Governance- und Sicherheitsrisiko, noch bevor ein Richtliniendokument geschrieben ist. Es ist die günstigste verfügbare Governance-Entscheidung, getroffen in der Architektur, nicht in einem Policy-Ordner.
Oberhalb der Edge dreht sich das Governance-Gespräch vor allem darum, wem die Bedeutung eines Tags gehört, sobald es die Maschine verlässt. Eine Plattformschicht, die jedes Team seine eigene Version von „Ausstoß Linie 3“ definieren lässt, erzeugt dieselbe Abstimmungslast wie im Abschnitt zum Skalierungsversagen — nur verteilt über die Compliance-Berichterstattung statt über einen stockenden Piloten. Namensgebung und Kontexteigentümerschaft gehören zu einer einzigen zurechenbaren Funktion, nicht zu wem auch immer zuerst gefragt hat.
Zur regulatorischen Landschaft selbst beschreiben wir das Terrain, statt Ihnen zu sagen, wozu es Sie verpflichtet — diese Einschätzung liegt bei Ihrer Rechtsabteilung und Ihrer konkreten Anlage. Europäische Hersteller bewegen sich derzeit durch eine Phase, in der die Pflichten zur Netz- und Informationssicherheit aus der NIS2-Richtlinie in unterschiedlichem Tempo in nationales Recht übertragen werden, in der die risikogestuften Pflichten des EU AI Acts über einen mehrjährigen Zeitplan schrittweise in Kraft treten, und in der der EU Data Act und die DSGVO weiterhin mitbestimmen, welche industriellen Daten bewegt, geteilt und aufbewahrt werden dürfen und auf welcher Grundlage. Was sich klar sagen lässt, weil es eine Architektureigenschaft ist und keine Rechtsauskunft: Ein System, das standardmäßig mit personenbereinigten, rollenbezogenen Maschinendaten arbeitet und jede personenbezogene Zuordnung als explizite Opt-in-Option statt als Grundeinstellung behandelt, lässt sich unter jedem dieser Rahmenwerke leichter verteidigen als ein System, das diese Grenze nie mitgedacht und erst unter Prüfungsdruck nachgerüstet hat. Rückverfolgbarkeit, die sich aus guter Datenarchitektur von selbst ergibt — ein Datensatz je Teil, der bereits existiert, weil die Kontextschicht Auftrag, Charge und Prozesszustand erfasst hat —, ist ein Nebeneffekt, den man sich um seiner selbst willen wünschen sollte. Wo sich diese Überlegung mit produktpassähnlichem regulatorischem Denken in Europa berührt, behandeln wir das in Jenseits des Dashboards.
Die Sicherheitshaltung folgt derselben Logik: Zertifikatsbasierte Authentifizierung ist nur so gut wie die Disziplin dahinter. Ein Team, das verschlüsselte Sitzungen aufsetzt und dann jeden Client so konfiguriert, dass er allem vertraut, hat die Leistungskosten von Sicherheit bezahlt, ohne einen ihrer Vorteile zu kaufen — ein Muster, das auf echten Werkhallen häufig genug vorkommt, dass es benannt gehört.
Entscheidungsrahmen
Bevor Sie die nächste Stufe einer Automatisierungsinvestition freigeben, leisten fünf Fragen mehr diagnostische Arbeit als eine Reifegrad-Umfrage.
1. Was gibt die Edge-Schicht tatsächlich preis — verifiziert, nicht angenommen? Nicht, was die ursprüngliche Inbetriebnahme-Dokumentation behauptet, und nicht, was ein Herstellerdatenblatt als unterstützt aufführt. Was ein Live-Lesezugriff gegen die tatsächlich installierte Steuerung heute liefert, auf genau dieser Firmware.
2. Wem gehört der Tag-Namensraum, namentlich? Wenn die ehrliche Antwort lautet „wer auch immer der ursprüngliche Integrator war, und seither niemand“, dann ist diese Eigentümerschaftslücke der einzige Fix mit dem höchsten Hebel, der verfügbar ist — und er ist organisatorisch, bevor er technisch ist.
3. Was behält Ihr Historian tatsächlich, in welcher Auflösung, nach der Kompression? Ein Modell oder eine KI-Initiative, die auf der Annahme roh aufgelöster Daten aufbaut, die der Historian nie gespeichert hat, wird auf eine Weise unterdurchschnittlich abschneiden, die wie ein Modellierungsproblem aussieht — tatsächlich aber ein Datenaufbewahrungsproblem ist, geerbt von einer jahrzehntealten Speicherentscheidung.
4. Wo endet eine erkannte Abweichung derzeit — auf einem Bildschirm, oder bei einer Handlung? Wenn jede Anomalie, die Ihr System zutage fördert, noch immer einen Menschen braucht, der sie bemerkt, interpretiert und manuell über eine Reaktion entscheidet und sie ausführt, haben Sie Sichtbarkeit gebaut, keine Entscheidungsarchitektur. Diese Lücke — und was ihre verantwortungsvolle Schließung erfordert — ist ausführlich dargestellt in Smart Factories sind noch nicht smart.
5. Wie hoch ist die tatsächliche wirtschaftliche Exposition, den jetzigen Zustand zu belassen? Die Bandbreiten variieren je nach Werk und Produkt, aber ein brauchbarer Anker: Ungeplanter Stillstand kostet üblicherweise 5.000 bis 20.000 Euro pro Stunde, Ausschussverluste liegen üblicherweise bei 5 bis 15 Prozent der Ausbringung, und Energieineffizienz liegt üblicherweise bei 10 bis 25 Prozent — mit Herleitung und den Vorbehalten dazu im selben Beitrag. Die Zahlen eines konkreten Werks können überall innerhalb oder außerhalb dieser Bandbreite liegen; der Sinn der Frage ist, die Schätzung explizit zu erzwingen, mit einer angehängten Zahl, statt sie als angenommene Rechtfertigung stehen zu lassen, die niemand tatsächlich berechnet hat.
Diese fünf Fragen zählen mehr als ein Reifegrad-Score, weil jede sich innerhalb einer Woche auf dem eigenen Werksboden falsifizieren lässt, ohne Anbieter im Raum. Ein Reifegrad-Score sagt Ihnen, wo Sie stehen. Diese Fragen sagen Ihnen, was zuerst zu beheben ist.
Zusammenfassung: Einordnung für den Vorstand
Industrielle Automatisierung kam nicht in Phasen, die spätere Phasen ersetzt haben. Sie kam in Schichten, auf die spätere Schichten aufgebaut werden mussten, und jede leistet heute irgendwo auf einer Produktionsfläche noch reale Arbeit. Automatisierungsreife als zu erklimmende Leiter zu behandeln, diagnostiziert die eigentliche Randbedingung falsch — Adressierbarkeit: wie weit ein Signal reist, durch wie viele undokumentierte Übergaben, bevor darauf gehandelt werden kann, ohne dass ein Mensch es zuerst erklären muss.
Die für den Vorstand relevante Konsequenz: Die Investition mit dem höchsten Hebel ist selten die neueste sichtbare Schicht — noch ein Dashboard, noch ein KI-Pilot — und fast immer die am wenigsten sichtbare: Namensdisziplin in der Plattformschicht, Eigentümerschaft am Tag-Namensraum, ein ehrlicher Audit dessen, was der Historian bewahrt hat. Initiativen, die das überspringen und direkt auf unerforschtem Sediment aufbauen, sind jene, die bei Maschine eins funktionieren und bei Maschine fünf ins Stocken geraten — zu Kosten, die sich mit jedem weiteren Standort verstärken, bevor die Architekturfrage gelöst ist.
Praktische Umsetzungscheckliste
- Die Edge-Schicht gegen Live-Lesezugriffe prüfen, nicht gegen Dokumentation — Protokoll für Protokoll, Steuerung für Steuerung.
- Einen einzigen zurechenbaren Eigentümer für den Tag-Namensraum benennen, bevor eine neue Integration freigegeben wird.
- Die tatsächlichen Kompressions- und Deadband-Einstellungen des Historians abrufen und bestätigen, welche Auflösung je Signalklasse wirklich erhalten bleibt.
- Jedes bestehende Punkt-zu-Punkt-Gateway kartieren, jedem einen Eigentümer zuweisen, und jene abschalten, für die niemand einen Eigentümer nennen kann.
- Jede neue Integration auf reinen Lesezugriff an der Steuerungsgrenze beschränken, sofern kein spezifischer, dokumentierter Grund Schreibzugriff erfordert.
- Mindestens eine Abweichung Ende-zu-Ende nachverfolgen, von der Erkennung bis zu der konkreten Handlung oder Nicht-Handlung, die sie derzeit auslöst, bevor eine neue Erkennungsschicht finanziert wird.
- Den Kosten des Nichtstuns eine explizite Euro-Schätzung anheften — mit den eigenen Stillstands-, Ausschuss- und Energiezahlen, nicht mit einem Branchendurchschnitt.
- Den Rollout über Maschine eins hinaus bewusst staffeln — Tag-Namensraum-Drift und Gateway-Eigentümerschaft für Maschine zwei bis Maschine dreißig einplanen, bevor der Pilot für erfolgreich erklärt wird.
Fragen, die Sie vor der nächsten Automatisierungsinvestition stellen sollten
- Wenn sich gerade jetzt ein Signal an einer Maschine ändert — durch wie viele undokumentierte Übersetzungen läuft es, bevor jemand darauf handeln kann, und kann irgendjemand im Raum diese Übersetzungen tatsächlich benennen?
- Wem gehört unser Tag-Namensraum heute, in der Praxis — nicht auf einem vor Jahren gezeichneten Organigramm?
- Was hat die Kompressionseinstellung unseres Historians still verworfen, und haben wir das je überprüft?
- Wenn unsere Überwachung eine Abweichung meldet, endet sie auf einem Bildschirm, oder erreicht sie eine konkrete, zurechenbare Handlung?
- Welches unserer Punkt-zu-Punkt-Gateways hat keinen benannten Eigentümer, und was passiert an dem Tag, an dem es still aufhört, Daten weiterzuleiten?
- Würden wir unseren aktuellen Piloten genau so, wie er heute steht, auf die nächsten dreißig Maschinen hochskalieren — welche dieser Maschinen würde ihn zuerst zum Scheitern bringen, und warum?
- Was würde es uns in Euro kosten, die jetzige Lücke ein weiteres Jahr lang exakt so zu belassen — und haben wir diese Zahl tatsächlich berechnet, oder nur angenommen?
Nichts davon braucht neue Technologie, um beantwortet zu werden. Es braucht jemanden, der bereit ist, den Schaltschrank zu öffnen, die tatsächlichen Einstellungen des Historians zu lesen und zu fragen, wer seit einem Jahrzehnt still entscheidet, was ein Tag bedeutet. Die Werke, die über Maschine eins hinaus skalieren, sind nicht die mit der neuesten KI-Schicht. Es sind die, die diesen Audit zuerst gemacht haben.
Erweiterter Volltext — Board-Report-Format
Zusammenfassung
Automatisierungsgeschichte ist Sediment, keine Treppe. Die vertraute Leiter — erst SPS, dann SCADA, dann IoT, dann KI, dann Autonomie — beschreibt eine Anbieter-Roadmap, kein arbeitendes Werk. Jede Generation seit dem späten Jahrzehnt der 1960er-Jahre ist auf den meisten Hallenflächen bis heute präsent und tragend. Die Kennzahl, die tatsächlich vorhersagt, ob eine KI- oder IoT-Initiative skaliert, ist Adressierbarkeit: wie weit ein Signal reist, durch wie viele undokumentierte Übergaben, bevor darauf gehandelt werden kann, ohne dass es ein Mensch erklären muss.
Was jede Schicht tatsächlich hinterlassen hat
Steuerungsebene: deterministische Scan-Zyklus-Logik, gebaut für feste Zyklen und vertrauenswürdige Segmente — keine Altlast, sondern bis heute die richtige Antwort für geschlossene Regelkreise und Sicherheitssteuerung, und der Grund, warum entsprechende Protokolle noch immer den Großteil dessen ausmachen, was eine Werkhalle spricht.
SCADA-/Historian-Ebene: der Tag-Namensraum, von einem Integrator bei der Inbetriebnahme unter Termindruck gewählt und seither unhinterfragt geerbt; sowie die Deadband-Kompression, vor Jahrzehnten ein vernünftiger Speicherkompromiss, der still die Signaltextur verworfen hat, die ein Zustandsüberwachungsmodell heute braucht.
Transportebene: ein größtenteils gelöstes Problem — Bytes zuverlässig bewegen —, das mit dem schwierigeren, ungelösten Problem verwechselt wird: dass sich zwei Systeme darauf einigen, was ein Signal bedeutet.
Warum Rollouts zwischen Maschine eins und Maschine dreißig ins Stocken geraten
Piloten, die auf Maschine eins gebaut sind, kodieren still deren Namens- und Abtastannahmen. Maschine zwei, drei und weitere verletzen diese Annahmen strukturell: unterschiedliche Tag-Konventionen, nicht zugeordnete Gateways, eine Historian-Auflösung, die nicht zum Pilot passt. Nichts davon ist ein Versagen der IoT-Werkzeuge — es ist das, was passiert, wenn Skalierung als Tempoproblem behandelt wird statt als Architekturdisziplin.
Governance und die europäische Regulierungslandschaft
Reiner Lesezugriff an der Steuerungsgrenze entfernt eine ganze Kategorie von Governance- und Sicherheitsrisiko, noch bevor eine Richtlinie geschrieben ist. Die Eigentümerschaft am Tag-Namensraum gehört zu einer einzigen zurechenbaren Funktion. Zu NIS2, dem EU AI Act, dem EU Data Act und der DSGVO beschreibt dieser Report das Terrain — gestufte Pflichten, die über mehrjährige Zeitpläne in Kraft treten —, ohne zu behaupten, wozu eine konkrete Anlage verpflichtet ist; das ist Sache der Rechtsabteilung. Eine Architektureigenschaft, keine Rechtsauskunft: personenbereinigte, rollenbezogene Daten als Grundeinstellung, mit personenbezogener Zuordnung als Opt-in, lassen sich strukturell leichter verteidigen als ein System, das diese Grenze nie gezogen hat.
Entscheidungsrahmen
Fünf Fragen vor der nächsten Investition: (1) Was gibt die Edge-Schicht heute nachweislich preis, nicht auf dem Papier; (2) wem gehört der Tag-Namensraum, namentlich; (3) welche Auflösung behält der Historian tatsächlich nach der Kompression; (4) erreicht eine erkannte Abweichung eine Handlung, oder endet sie auf einem Bildschirm; (5) wie hoch ist die berechnete, nicht angenommene Euro-Exposition, die Lücke so zu belassen — verankert an typischen Bandbreiten von 5.000 bis 20.000 Euro pro Stunde Stillstand, 5 bis 15 Prozent Ausschuss und 10 bis 25 Prozent Energieineffizienz, hergeleitet und mit Quelle in Smart Factories Aren't Smart Yet.
Praktische Umsetzungscheckliste
Die Edge-Schicht gegen Live-Lesezugriffe prüfen. Einen Tag-Namensraum-Eigentümer benennen. Die tatsächlichen Kompressionseinstellungen des Historians prüfen. Jedes Punkt-zu-Punkt-Gateway kartieren und einem Eigentümer zuweisen. Neue Integrationen standardmäßig auf reinen Lesezugriff an der Steuerungsgrenze beschränken. Eine Abweichung Ende-zu-Ende nachverfolgen, bevor neue Erkennung finanziert wird. Dem Nichtstun eine reale Euro-Zahl anheften. Maschine zwei bis Maschine dreißig explizit einplanen, bevor der Pilot für erfolgreich erklärt wird.
Schluss
Die Werke, die über Maschine eins hinaus skalieren, sind nicht die mit der neuesten KI-Schicht. Es sind die, die zuerst das Sediment geprüft haben.
Ankit aktualisiert am 19 Nov 2024, 10:15AM
This breakdown of automation maturity is extremely practical. We’re currently between SCADA and IoT layers and struggling with integration gaps.Jonas aktualisiert am 19 Nov 2024, 12:05PM
Same here. The biggest issue for us is contextualizing machine data with production orders. Without that, analytics feels disconnected.Priya aktualisiert am 20 Nov 2024, 08:30AM
The shift from reactive to predictive systems is where real ROI lies. We saw downtime reduction once we integrated edge analytics.Markus aktualisiert am 21 Nov 2024, 02:10PM
The architecture diagram clarified a lot. Especially the separation between edge, platform, and enterprise layers—this is often misunderstood internally.Elena aktualisiert am 21 Nov 2024, 03:45PM
Yes, and governance becomes much easier once responsibilities are split across layers instead of a monolithic system.Ravi aktualisiert am 22 Nov 2024, 11:20AM
Interesting point on autonomous factories. But realistically, how many companies are actually achieving that level today?Thomas aktualisiert am 22 Nov 2024, 01:05PM
Very few. But the roadmap matters more than the destination. Incremental autonomy—like self-adjusting processes—is already happening.Sophie aktualisiert am 23 Nov 2024, 09:55AM
The inclusion of audio/video is great. Makes it easier to consume depending on time constraints.Arjun aktualisiert am 24 Nov 2024, 04:25PM
Would love a follow-up on implementation cost models and ROI benchmarks across industries.