
Predictive Maintenance 2026: Das meiste, was funktioniert, ist keine Vorhersage
Zwei Umfragen, im Abstand eines Jahres veröffentlicht, beschreiben denselben Markt. Die eine meldet, der Einsatz von Predictive Maintenance habe sich verdoppelt. Die andere meldet einen Rückgang. Beides kann stimmen – und warum, ist das Nützlichste, was ein Instandhaltungsleiter vor jeder Unterschrift über diese Kategorie wissen sollte.
Dieser Beitrag behandelt den Unterschied zwischen zeitbasierter, zustandsorientierter und vorausschauender Instandhaltung; warum vieles, was als „vorausschauend“ verkauft wird, in Wahrheit die mittlere ist; und wie Sie die wenigen Maschinen wählen, an denen sich echte Vorhersage bezahlt macht.
Industrielle Realität
Ein typisches Pilotprojekt: Es wird an der wichtigsten Maschine des Werks aufgesetzt. Das liegt nahe – ihr Stillstand kostet am meisten, also wäre ihre Vorhersage am meisten wert. Sensoren kommen dran, Daten fließen, ein Modell wird trainiert, ein Dashboard zeigt einen grünen Gesundheitswert.
Anderthalb Jahre später ist der Wert noch immer grün, und das Projekt wird still abgewickelt. Nichts ist schiefgegangen, und genau das ist das Problem. Die Maschine fiel nicht aus, also sagte das Modell nie einen Ausfall vorher, also kann niemand zeigen, was das Projekt eingespart hat.
Sie fiel nicht aus, weil sie die wichtigste Maschine des Werks ist. Sie hat das kürzeste Wartungsintervall, den erfahrensten Techniker, die Ersatzteile im Regal und den Bediener, der ein verändertes Geräusch vor jedem Sensor bemerkt. Die Anlage mit der meisten Aufmerksamkeit hat die wenigsten Ausfälle, aus denen sich lernen ließe. Der Pilot stand genau dort, wo eine Vorhersage am wenigsten hinzufügen konnte.
Unterdessen fällt eine Kühlmittelpumpe an einer unauffälligen Linie alle paar Monate aus, meist am Wochenende, und wird erst an der Ausschussquote vom Montag bemerkt.
Das ist keine Geschichte über ein schlechtes Modell, sondern darüber, was ein Modell braucht und wo es das vorfindet.
Warum das Problem strukturell ist
Drei Strategien, die im Englischen zu einer verschwimmen
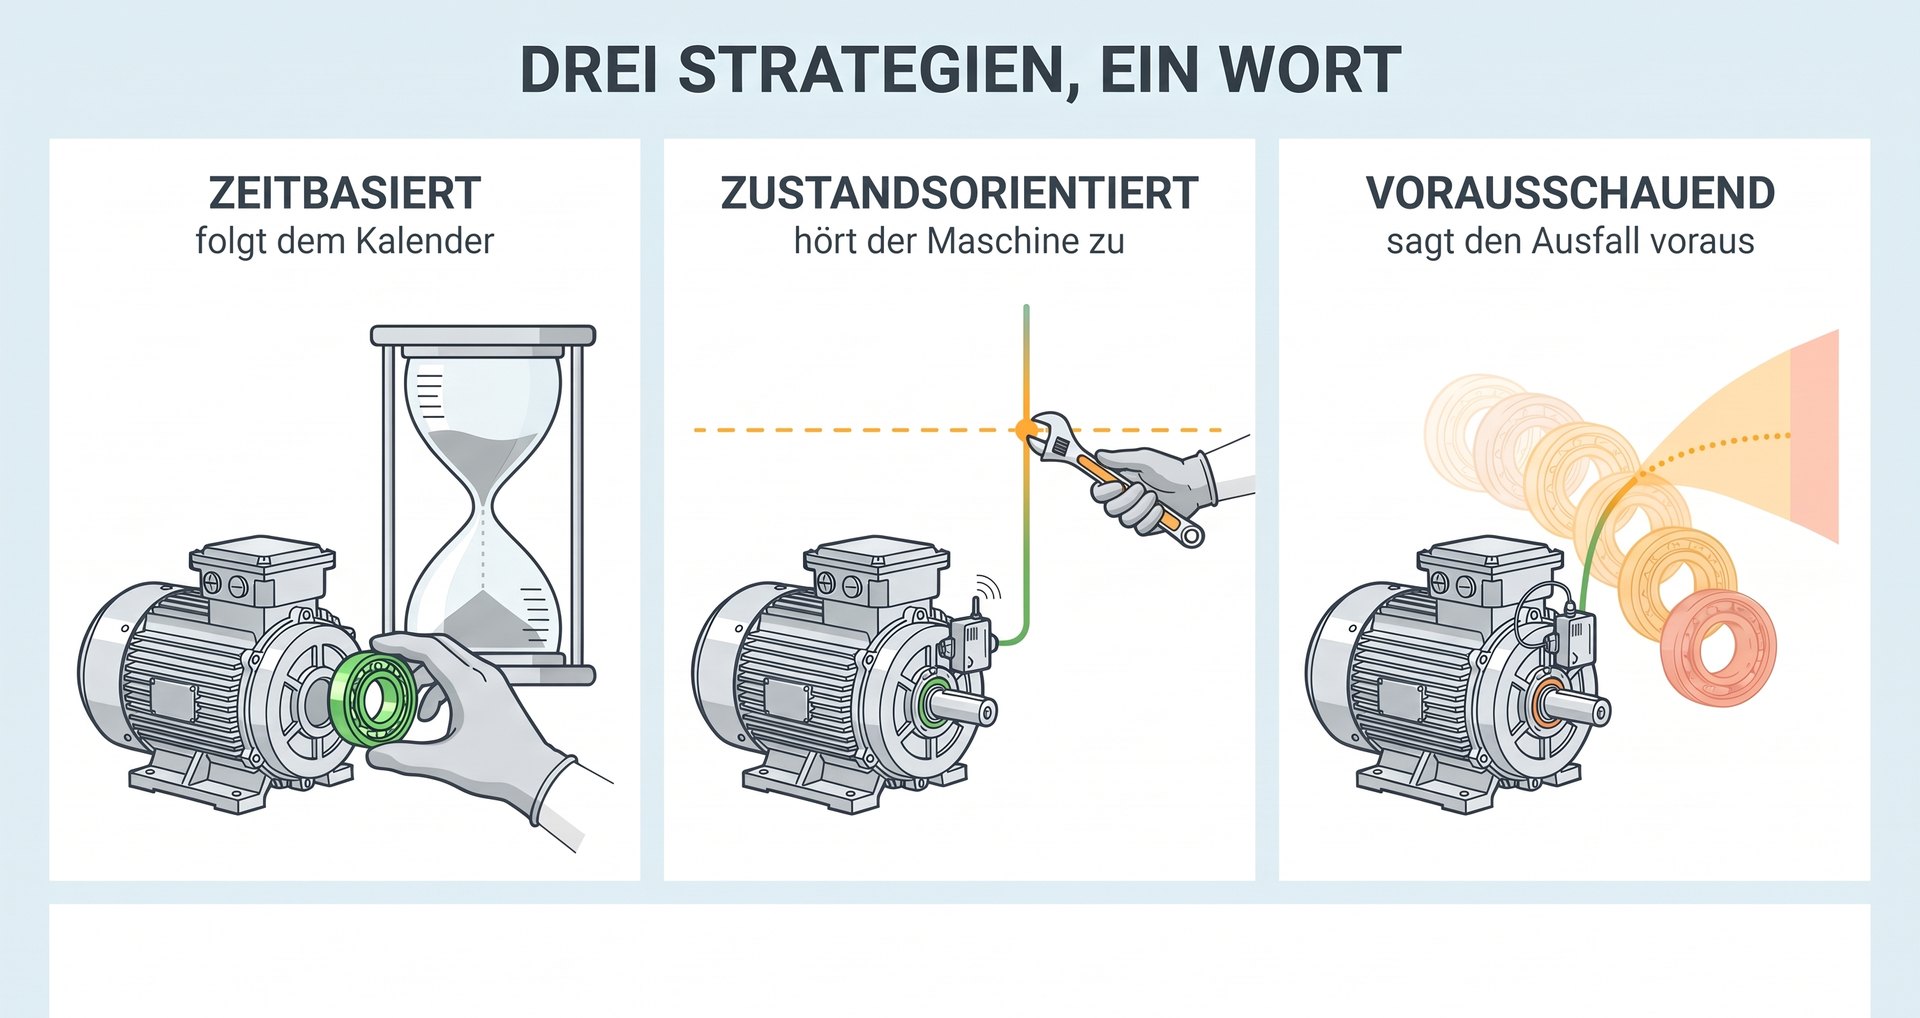
Die deutsche Instandhaltungspraxis hält diese Dinge sprachlich auseinander. DIN 31051 gliedert die Instandhaltung in vier Grundmaßnahmen – Wartung, Inspektion, Instandsetzung und Verbesserung –, und die Praxis benennt die Strategien getrennt: zeitbasierte, zustandsorientierte und vorausschauende Instandhaltung. Im Englischen werden die letzten beiden routinemäßig unter einem Namen verkauft.
- Zeitbasiert (präventiv): Tausch oder Wartung nach Kalender oder Zähler. Nach einer festen Zahl von Betriebsstunden, jedes Quartal, nach einer festen Zahl von Zyklen. Einfach, planbar und blind für den tatsächlichen Zustand des Bauteils.
- Zustandsorientiert: Etwas messen, das sich mit dem Verschleiß des Bauteils ändert – Schwingung, Temperatur, Stromaufnahme, Druck, Partikelzahl – und handeln, wenn es eine selbst gesetzte Grenze überschreitet. Kein Modell nötig. Ein Grenzwert und ein Mensch, der darauf reagiert.
- Vorausschauend: Prognostizieren, wann das Bauteil seine Grenze erreicht. Die einfachste Form schreibt den Signaltrend fort. Ein Modell, trainiert daran, wie vergleichbare Bauteile verschlissen und ausgefallen sind, ist die Form, die eine dokumentierte Ausfallhistorie braucht – und die am häufigsten verkaufte.
Viele Erfolgsgeschichten der Kategorie sind bei näherem Hinsehen zustandsorientierte Instandhaltung mit bewusst gesetzten Grenzwerten. Sie vorausschauend zu nennen, ist eine Marketingentscheidung, keine technische.
Die meisten Ausfälle halten sich nicht an den Kalender
Die Einwände gegen reine Kalenderwartung sind älter als jede Software auf diesem Markt. 1978 veröffentlichten F. Stanley Nowlan und Howard Heap für das US-Verteidigungsministerium ihre Studie über Bauteile ziviler Flugzeuge, den Bericht, der die zuverlässigkeitsorientierte Instandhaltung begründete. Sie trugen die Ausfallwahrscheinlichkeit über dem Alter auf und fanden, dass nur eine kleine Minderheit der untersuchten Teile eine Verschleißzone zeigte, in der eine Altersgrenze hilft. Rund 89 Prozent zeigten überhaupt keine. Bei diesen senkte planmäßiger Tausch die Ausfälle nicht, und zu früher Tausch konnte die Ausfälle hinzufügen, die ein frisch eingebautes Bauteil mit sich bringt.
Flugzeuge sind keine Werkzeugmaschinen, und die genauen Anteile lassen sich nicht auf eine Fabrik übertragen. Das Prinzip schon: Ein festes Intervall hilft nur Bauteilen, die vorhersehbar altern. Für alles andere rät der Kalender.
Vorhersage braucht Ausfälle, und Werke beheben Ausfälle, ohne sie zu dokumentieren
Ein Vorhersagemodell lernt den Unterschied zwischen einer gesunden und einer ausfallgefährdeten Maschine an Beispielen für beides. Gesunde Daten gibt es reichlich. Ausfalldaten sind naturgemäß selten, weil ein gut geführtes Werk Ausfälle verhindert und die eintretenden schnell behebt.
Schlimmer: Instandsetzungen werden selten in einer Form dokumentiert, die ein Modell nutzen kann. Ein Stillstandseintrag sagt, dass die Maschine vier Stunden stand. Selten steht darin, welches Bauteil wie ausfiel und wie die Signale in den Wochen davor aussahen. Zehn Jahre Sensordaten ohne gekennzeichnete Ausfälle sind kein Trainingsdatensatz für ein Ausfallmodell. Keine Modellierungstechnik erzeugt die Beispiele, die das Werk nie erfasst hat.
Eine Warnung ist nur etwas wert, wenn jemand handeln kann
Eine Vorhersage sechs Wochen im Voraus nützt nur, wenn das Ersatzteil in sechs Wochen verfügbar ist, der Stillstand geplant werden kann und jemand eingeteilt ist, ihn zu planen. Dauert die Lieferung länger als der Vorlauf der Warnung, oder landet die Warnung in einem Postfach, für das niemand zuständig ist, war die Vorhersage richtig, und der Ausfall tritt trotzdem ein.
Warum gerade jetzt
Der Markt sendet widersprüchliche Signale – der Anlass für diesen Beitrag.
Im Mai 2026 meldete eine Umfrage im Auftrag eines Messgeräteherstellers unter rund 600 leitenden Entscheidern und Instandhaltungsfachleuten aus vier Fertigungsbranchen in Deutschland, Großbritannien und den USA, der Einsatz von Predictive Maintenance habe sich binnen eines Jahres verdoppelt, von 9 auf 18 Prozent. Proaktive Instandhaltung fiel von 55 auf 45 Prozent, reaktive blieb unverändert bei 36 Prozent. Laut derselben Studie hingen rund 78 Prozent der genannten Hindernisse mit Qualifikation zusammen.
Ein Jahr zuvor verzeichnete The 2025 State of Industrial Maintenance, ein Jahresbericht eines Instandhaltungssoftware-Anbieters, beim Einsatz von Predictive Maintenance einen Rückgang von 30 Prozent (2024) auf 27 Prozent (2025) – während 65 Prozent der Instandhaltungsteams erwarteten, binnen zwölf Monaten KI einzuführen, und 71 Prozent die präventive Instandhaltung als ihre Hauptstrategie nannten.
Legen Sie die Ausgangswerte nebeneinander: Die eine Umfrage startete bei 9 Prozent, die andere bei 30 Prozent, bevor sie auf 27 sank. Wie auch immer die Erhebungszeiträume genau liegen – ein etwa dreifacher Abstand im selben Zeitraum heißt: Die Umfragen zählen nicht dasselbe. Beide sind von Unternehmen beauftragt, die an die Instandhaltung verkaufen, und keine veröffentlicht in den hier zitierten Zusammenfassungen ihren genauen Fragewortlaut. Das Wort „vorausschauend“ deckt heute alles ab, vom Schwingungsalarm bis zum Modell für die Restnutzungsdauer, und Umfragen messen, was die Befragten darunter verstehen.
Für Käufer zählt diese Unschärfe mehr als jede Zahl. Schließt die Definition eines Anbieters einen Grenzwertalarm ein, wirkt die Vorführung überzeugend – und der Business Case beruht auf etwas anderem.
Architektur im Detail
Beim Ausfallmodus beginnen, nicht beim Sensor
Die ergiebige Frage ist nicht, welche Sensoren nachzurüsten sind, sondern: Wie fällt diese Maschine tatsächlich aus, und kündigt sich dieser Ausfall an?
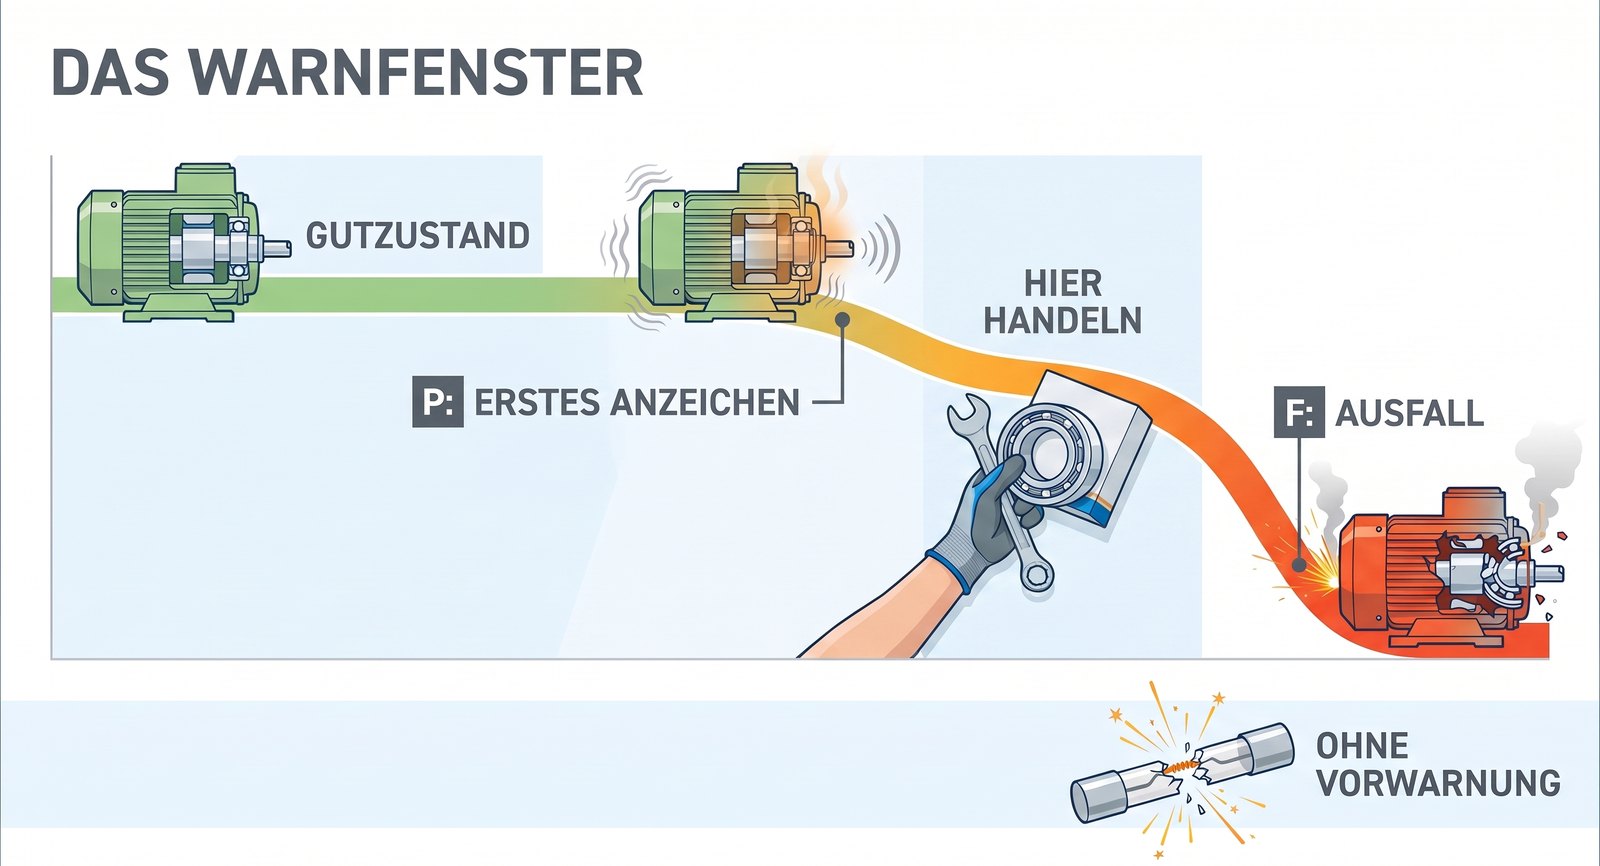
Zuverlässigkeitsingenieure nennen das P-F-Intervall: die Zeit zwischen dem Punkt, an dem ein sich anbahnender Ausfall erkennbar wird (P), und dem Funktionsausfall (F). Ein allmählich verschleißendes Lager zeigt wochenlang steigende Schwingung, bevor es sich festfrisst. Eine Sicherung, ein Softwarefehler oder eine Kollision mit einer Vorrichtung liefert nichts. Nur Ausfälle mit nutzbarem P-F-Intervall lassen sich durch Zustandsüberwachung erkennen oder durch ein Modell vorhersagen – und das Intervall muss länger sein als Ihr Inspektionsintervall plus die Lieferzeit des Ersatzteils, sonst kommt die Warnung zu spät. Alles andere braucht eine andere Antwort: Redundanz, ein Ersatzteil im Regal oder Hinnehmen.
Das Signal zum Ausfall passend wählen
Jeder fortschreitende Ausfallmodus hat Signale, die ihn typischerweise zeigen:
- Rotierende Teile – Lager, Spindeln, Getriebe, Pumpen, Lüfter: Schwingung, später im Verschleißverlauf oft auch Temperatur.
- Antriebe und Motoren: Stromaufnahme und ihr Verlauf über einen Zyklus.
- Hydraulik und Pneumatik: Druck, Durchfluss, Leckage, Zykluszeit eines Stellglieds.
- Schmierung und Fluide: Partikelzahl, Verschmutzung, Temperatur.
- Schneidwerkzeuge: Spindellast und die Werkzeugdaten, die die Steuerung ohnehin führt.
Viele Maschinen messen einiges davon schon zum Eigenschutz. Klären Sie vor jedem Sensorkauf, was Steuerung und Antriebe schon bereitstellen. Unser Beitrag über IoT-Sensortypen zeigt, was jede Sensorklasse aussagen kann und was nicht.
Ein Grenzwert mit Zuständigem schlägt ein Modell ohne
Bei den meisten fortschreitenden Ausfallmodi beginnt man am besten mit einem einfachen Aufbau: ein Signal, eine Referenzmessung im nachweislichen Gutzustand, ein Warn- und ein Eingriffsgrenzwert und eine namentlich benannte Person, die die Warnung erhält und entscheidet, was geschieht. Das ist zustandsorientierte Instandhaltung, und sie braucht keinerlei Ausfallhistorie. Wo noch keine gesunde Referenz existiert, sind die Schwingungszonen nach ISO 20816 der übliche allgemeine Ausgangspunkt, bis die maschineneigene Referenz sie ablöst.
Setzen Sie die Grenzwerte bewusst und schreiben Sie sie auf. Prüfen Sie sie nach dem ersten Monat: Ein Grenzwert, der täglich auslöst, ist nach einer Woche stummgeschaltet, und einer, der nie auslöst, schützt nichts.
Wann ein Modell seinen Platz verdient
Ein Modell bringt gegenüber einem Grenzwert erst dann etwas, wenn drei Dinge zutreffen: Das Werk hat viele gleichartige Anlagen, sodass die Ausfälle im Maschinenpark zusammen eine nutzbare Historie ergeben; die Ausfälle wurden mit Modus und Ursache dokumentiert; und die Entscheidung, die das Modell stützt, ist mit einem geschätzten Datum mehr wert als mit einer einfachen Warnung – etwa weil ein Stillstand Wochen im Voraus eingeplant oder ein Ersatzteil bestellt werden muss.
Wo diese Bedingungen gelten, verlangen Sie eine Spanne, keine Zahl. Eine Restnutzungsdauer als Fenster von Wochen, mit angegebener Konfidenz, lässt sich einplanen. Eine einzelne Zahl liegt irgendwann sichtbar daneben, und beim zweiten Mal liest der Planer sie nicht mehr.
Das Muster, das funktioniert
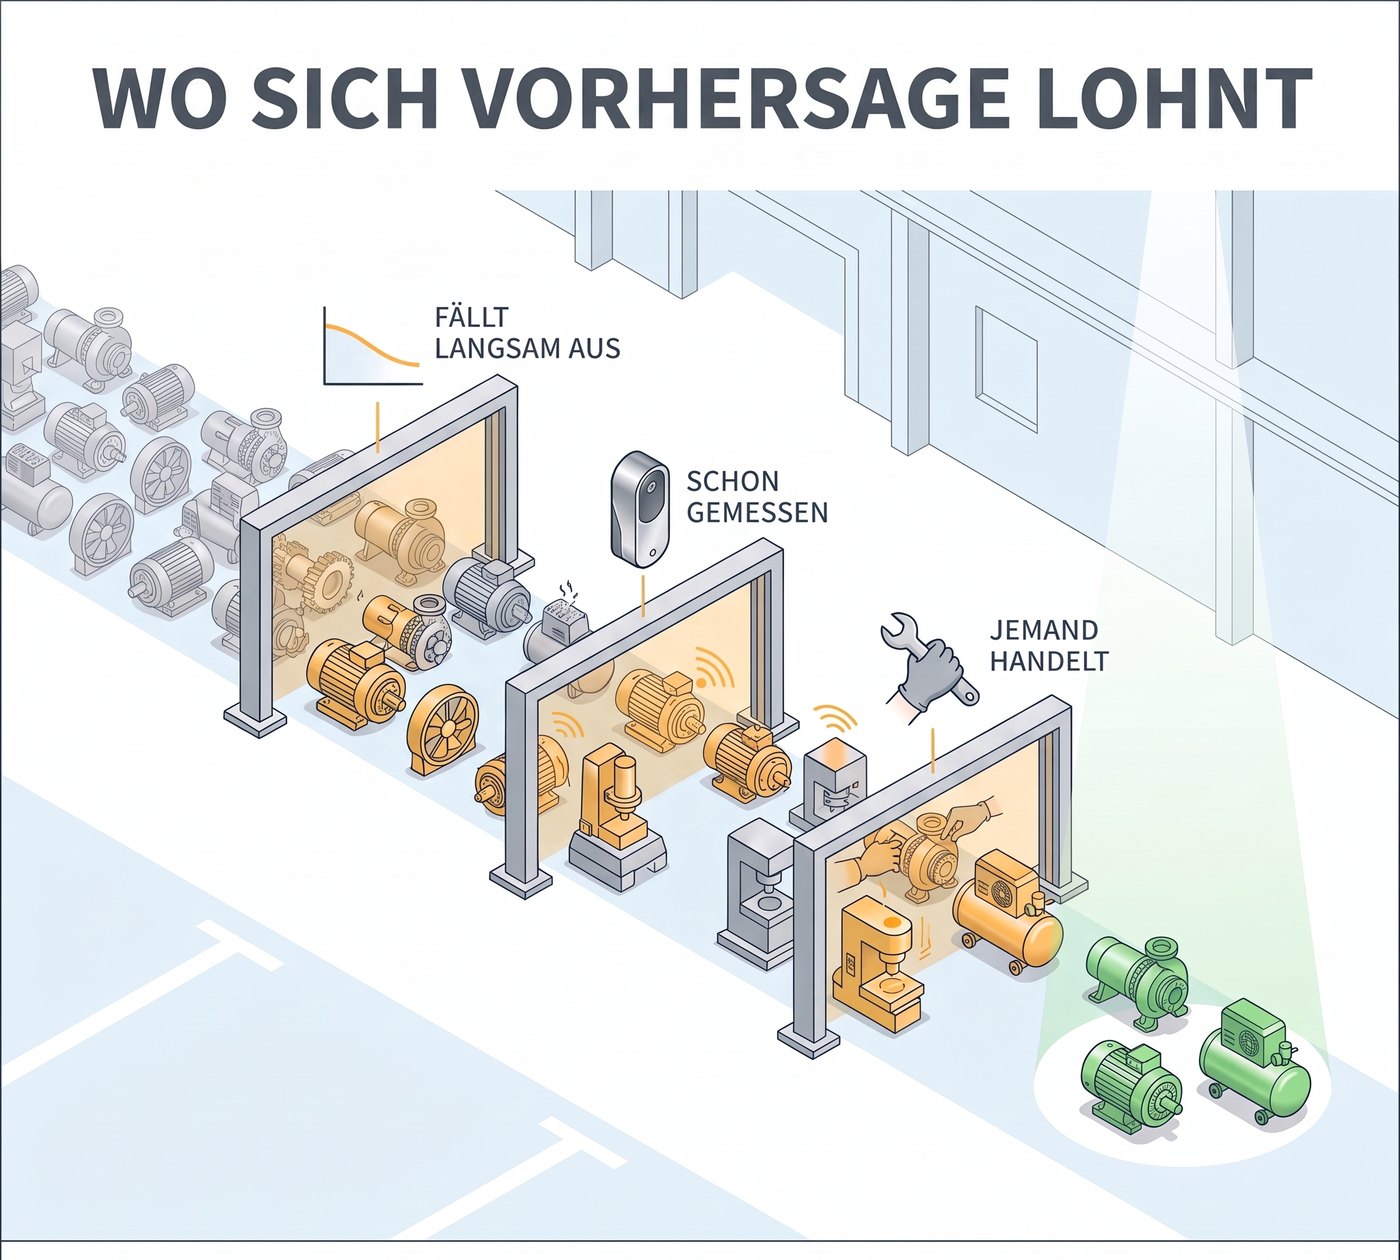
Die Maschinen nach drei Bedingungen wählen, die alle erfüllt sein müssen, nicht allein nach Kritikalität: Die Maschine fällt fortschreitend aus, das Signal wird schon gemessen oder lässt sich günstig ergänzen, und jemand handelt rechtzeitig auf eine Warnung.
Die Ausfallarten aufschreiben, auf die Sie achten wollen und wie sich jeder in den Daten zeigt, bevor irgendetwas installiert wird.
Mit Grenzwerten beginnen, mit einer gesunden Referenz und einem namentlich Zuständigen für jede Warnung.
Ab heute jeden Ausfall sauber dokumentieren: Bauteil, Modus, Ursache und der Zeitpunkt des ersten Signals. Das ist der Trainingsdatensatz, den Sie in zwei Jahren brauchen.
Erfolg als vermiedene oder verkürzte Stillstände messen, verglichen mit dem Vorjahr an denselben Maschinen – nicht als Modellgenauigkeit.
Ein Modell nur dort ergänzen, wo der Grenzwert das Signal bestätigt und der Maschinenpark die Historie geliefert hat. Unser Beitrag darüber, warum KI ohne Kontext scheitert, erklärt, warum das Modell die letzte Schicht ist, nicht die erste.
Warum die meisten Predictive-Maintenance-Projekte nicht skalieren
Der Pilot an der kritischsten Anlage. Sie hat die meiste Redundanz, die meiste Aufmerksamkeit und damit die wenigsten Ausfälle. Das Projekt kann nichts beweisen und wird beendet, weil es nichts bewiesen hat.
Die ungekennzeichnete Historie. Jahre an Daten, aber keine Aufzeichnung, was wann und warum kaputtging. Das Modell hat nichts, woran es den Ausfall lernen könnte, also lernt es den Normalbetrieb und nennt jede ungewöhnliche Woche eine Anomalie.
Alarmmüdigkeit. Grenzwerte, die alles erfassen sollen. Die Instandhaltung erhält Dutzende Warnungen pro Woche, findet die meisten harmlos und schaltet das System stumm. Technisch läuft es weiter, praktisch ist es aus.
Restnutzungsdauer als einzelne Zahl. Ein selbstsicherer Countdown an einer Anlage, deren Ausfallverhalten niemand beschrieben hat. Er liegt so daneben, dass der Planer es sieht, und das Vertrauen kommt nicht zurück.
Die Warnung, für die niemand eingeteilt ist. Die Vorhersage stimmt, trifft an einem Freitag ein, und das Teil hat eine lange Lieferzeit. Der Ausfall kommt pünktlich.
Erfolg als Modellgenauigkeit definiert. An einer Maschine, die selten ausfällt, liegt ein Modell, das immer „gesund“ meldet, fast jeden Tag richtig und erkennt nichts. Genauigkeit ist die falsche Messlatte; vermiedene Stillstände sind die richtige.
Mehrere davon sind die Lücke aus unserem Beitrag über Dashboards: Ein Signal kann stimmen und trotzdem nichts ändern, weil weder eine Person noch ein Prozess darauf gewartet hat.
Governance, Sicherheit und Mitbestimmung
Der Betriebsrat. Zustandsdaten betreffen Maschinen, werden aber zusammen mit Schichtdaten erfasst, und Reaktionszeiten der Instandhaltung lassen sich Personen zuordnen. In Deutschland ist eine technische Einrichtung, die geeignet ist, Verhalten oder Leistung von Beschäftigten zu überwachen, mitbestimmungspflichtig und vor der Einführung mit dem Betriebsrat zu vereinbaren. Betrachtungseinheit bleiben Anlage und Ausfallmodus; zeigen Sie das Datenmodell früh und halten Sie schriftlich fest, wofür die Daten nicht verwendet werden.
Überwachung liest nur. Zustand zu beobachten heißt, Signale zu lesen. Sie erfordert nie, in eine Maschinensteuerung zu schreiben. Legen Sie das vorab fest und erzwingen Sie es an der Verbindung selbst, nicht nur per Richtlinie.
Einordnung ins Netz. Sensoren und Gateways in der Halle sitzen im Steuerungsnetz oder in dessen Nähe. Entscheiden Sie, in welchem Segment sie liegen, wer sie verwaltet und ob sie von außen erreichbar sind. Für die meisten Werke sollte die letzte Antwort Nein lauten.
Ihre Daten, Ihre Historie. Die Ausfallaufzeichnungen, die Sie jetzt beginnen, werden in den nächsten Jahren zum wertvollsten Gut Ihrer Instandhaltung. Sorgen Sie dafür, dass sie Ihnen gehören und exportierbar bleiben, gleich mit welchem Werkzeug erfasst.
Bewertungsrahmen für die Plattformauswahl
- Was meint der Anbieter mit „vorausschauend“? Einen Grenzwertalarm, eine Trendfortschreibung oder ein an Ausfällen trainiertes Modell? Lassen Sie sich zeigen, welches davon sein Referenzergebnis genutzt hat.
- Welche Ausfallhistorie braucht sein Ansatz, und haben Sie diese? Wenn gekennzeichnete Ausfälle nötig sind: wie viele, welchen Modus?
- Können Sie die Grenzwerte selbst setzen und verantworten, und sehen, warum eine Warnung ausgelöst hat?
- Wird die Restnutzungsdauer als Spanne mit ihrer Unsicherheit angegeben, oder als eine Zahl?
- Wohin geht die Warnung, und wie wird die Reaktion dokumentiert? Eine Warnung ohne Arbeitsauftrag ist eine Benachrichtigung, keine Instandhaltung.
- Können Sie Rohsignale und Ausfallaufzeichnungen exportieren, ohne Beratungsprojekt?
Zusammenfassung für die Geschäftsführung
Erstens. „Predictive Maintenance“ steht für drei verschiedene Dinge. Vieles, was unter diesem Namen verkauft wird, ist zustandsorientierte Instandhaltung – ein gemessenes Signal, ein bewusst gesetzter Grenzwert und ein namentlich Zuständiger –, die weder Ausfallhistorie noch Modell braucht.
Zweitens. Echte Vorhersage braucht Ausfallbeispiele, dokumentiert mit ihrer Ursache. Die meisten Werke haben Jahre an Sensordaten und wenige solcher Aufzeichnungen; die Investition mit dem längsten Nutzen ist daher, ab sofort Ausfälle sauber zu dokumentieren.
Drittens. Die richtigen ersten Maschinen sind nicht die kritischsten. Es sind die, die fortschreitend ausfallen, schon gemessen werden und bei denen jemand bereit ist zu handeln. Bewerten Sie das Programm an vermiedenen oder verkürzten Stillständen, nicht an Modellgenauigkeit, und erwarten Sie erste Belege von wenigen Maschinen binnen Monaten, nicht von einer werksweiten Plattform.
Das Fehlermuster, vor dem sich die Geschäftsführung hüten sollte: das Wort zu kaufen. Fragen Sie, was vorhergesagt wird, aus welcher Historie, und wer auf die Antwort hin handelt.
Praktische Umsetzungs-Checkliste
Bevor irgendetwas gekauft wird
- Die zehn Maschinen auflisten, deren Ausfälle im Vorjahr am meisten gekostet haben. Für jede notieren, wie sie ausfiel und ob es eine Vorwarnung gab.
- Kennzeichnen, welche Ausfallmodi fortschreitend und welche plötzlich sind. Nur die fortschreitenden kommen infrage.
- Prüfen, was jede infrage kommende Maschine schon misst – Steuerung, Antriebe, vorhandene Sensoren.
- Zählen, wie viele frühere Ausfälle an diesen Maschinen ein dokumentiertes Bauteil und eine Ursache haben. Liegt die Antwort nahe null, dort beginnen.
Drei Monate an wenigen Maschinen
- Für jeden Ausfallmodus eine gesunde Referenz für ein Signal aufnehmen.
- Einen Warn- und einen Eingriffsgrenzwert setzen und die Person benennen, die jede Warnung erhält.
- Jede Warnung protokollieren und was daraufhin geschah. Die Grenzwerte nach vier Wochen prüfen.
- Jeden Ausfall mit Bauteil, Modus, Ursache und Datum des ersten Signals dokumentieren.
Bevor ausgeweitet oder ein Modell ergänzt wird
- Die Stillstände an diesen Maschinen mit demselben Zeitraum des Vorjahres vergleichen.
- Nur wo sich ein Signal bewährt und der Maschinenpark eine Ausfallhistorie geliefert hat, ein Modell testen – und auf einer Spanne bestehen.
Eine Anmerkung zu unserem Standpunkt
Wir entwickeln Software in diesem Feld. Wir sind also nicht neutral, und es wäre seltsam, etwas anderes zu behaupten. Dieser Beitrag beschreibt bewusst nicht, was unsere Software kann. Alles oben Gesagte lässt sich im kleinen Maßstab beginnen – mit den Signalen, die Ihre Maschinen ohnehin bereitstellen, einem Notizbuch für Ausfallaufzeichnungen und einer Tabellenkalkulation –, und daran sollte man es messen.
Wenn Sie schnell sehen möchten, ob Ihre Maschinendaten dafür taugen: Wir stellen eine kostenlose Selbsteinschätzung bereit – criussoftware.com/res/kits/readiness/. Sie fragt nach einer geschäftlichen E-Mail-Adresse und Ihrer Einwilligung zur Kontaktaufnahme und zeigt ein bewertetes Ergebnis direkt am Bildschirm; mit einer Telefonnummer erhalten Sie den vollständigen Bericht per E-Mail. Sie ist eine Selbsteinschätzung, kein Audit.
Fragen für Ihre nächste Besprechung
- Wie viele dokumentierte Ausfälle mit Ursache – nicht nur einem Stillstandseintrag – haben Sie für die Maschine, an der Sie pilotieren würden?
- Fällt diese Maschine allmählich oder plötzlich aus? Nur eines davon lässt sich früh erkennen.
- Käme eine Warnung sechs Wochen vor einem Ausfall: Ist das Teil in sechs Wochen verfügbar, und wer plant den Stillstand?
- Wie viele Warnungen pro Woche würde Ihre Instandhaltung lesen, bevor sie aufhört, sie zu lesen?
- Messen Sie Erfolg an vermiedenen Stillständen oder an einer Modellgenauigkeit?
- Was müssten Sie ab heute dokumentieren, damit in zwei Jahren echte Vorhersage möglich ist – und tut das jemand?
- Wenn ein Anbieter Ihnen eine Restnutzungsdauer nennt: Welche Spanne gibt er dazu an?
Was am Ende zählt
Die meisten Maschinen fallen nicht nach Plan aus, also kann ein Kalender allein sie nicht am Laufen halten. Die meisten Werke haben nicht die Ausfallhistorie, die eine Vorhersage braucht, also kann es ein Modell allein auch nicht.
Was dazwischen funktioniert, ist unspektakulär: wissen, wie jede Maschine ausfällt, das Signal beobachten, das es zeigt, einen Grenzwert setzen und die Warnung einem Menschen geben, der handelt. Dokumentieren Sie jeden Ausfall so, als würde jemand daraus lernen – denn in zwei Jahren könnte es ein Modell tun.
Der Kalender rät. Die Maschine sagt es Ihnen – wenn jemand zuhört.
Quellen
- Fluke Corporation / Censuswide, Pressemitteilung vom 7. Mai 2026, Fluke Survey Finds Predictive Maintenance Adoption Doubles as Manufacturers Boost Digital Investment – rund 600 leitende Entscheider und Instandhaltungsfachleute aus vier Fertigungsbranchen, Deutschland, Großbritannien und USA; Predictive 9 % auf 18 %, proaktiv 55 % auf 45 %, reaktiv unverändert bei 36 %; qualifikationsbezogene Herausforderungen rund 78 % der genannten Hindernisse. https://www.finanznachrichten.de/nachrichten-2026-05/68425047-fluke-corporation-fluke-survey-finds-predictive-maintenance-adoption-doubles-as-manufacturers-boost-digital-investment-399.htm (abgerufen am 2026-10-12)
- The Manufacturer, 7. Mai 2026, Auswertung derselben Fluke-Umfrage für Großbritannien. https://www.themanufacturer.com/articles/fluke-survey-finds-predictive-maintenance-adoption-doubles-as-uk-manufacturers-boost-digital-investment/ (abgerufen am 2026-10-12)
- MaintainX, Maintenance statistics and trends, mit Bezug auf The 2025 State of Industrial Maintenance – Einsatz von Predictive Maintenance 30 % (2024) auf 27 % (2025); 65 % erwarten die Einführung von KI binnen zwölf Monaten; 71 % nennen präventive Instandhaltung als Hauptstrategie. https://www.getmaintainx.com/blog/maintenance-stats-trends-and-insights (abgerufen am 2026-10-12)
- F. Stanley Nowlan und Howard F. Heap, Reliability-Centered Maintenance, United Airlines für das US-Verteidigungsministerium, 1978 (DTIC AD-A066579); Zusammenfassung der sechs Ausfallmuster und des Anteils der Teile ohne Verschleißzone: https://reliamag.com/?p=266257 (abgerufen am 2026-10-12)
- DIN 31051, Grundlagen der Instandhaltung – nur für das Vokabular zitiert.
- ISO 20816, Mechanische Schwingungen – Messung und Bewertung der Schwingungen von Maschinen – zitiert als üblicher allgemeiner Bezug für Schwingungszonen.
Nehmen Sie die Maschine, an der Sie pilotieren würden, und zählen Sie ihre erfassten Ausfälle mit Ursache. Liegt die Zahl nahe null, ist das erste Projekt kein Modell. Es ist eine bessere Ausfalldokumentation, begonnen in dieser Woche.
Weiterlesen
- IoT-Sensortypen und ihre Datenanwendungen — was jede Sensorklasse über eine Maschine sagen kann und was nicht.
- Warum KI ohne Kontext in der Fertigung scheitert — warum das Modell die letzte Schicht ist, nicht die erste.
- Warum Ihr Dashboard nichts verändert hat — ein richtiges Signal ändert nichts ohne Verantwortlichen.
- Kurzstillstände: Die Verluste, die in keinem Bericht ankommen — Verluste, die nach Instandhaltung aussehen und keine sind.
Vollständiger Blogtext — Berichtsformat
Predictive Maintenance 2026: Das meiste, was funktioniert, ist keine Vorhersage
Zwei Umfragen, im Abstand eines Jahres veröffentlicht, beschreiben denselben Markt. Die eine meldet, der Einsatz von Predictive Maintenance habe sich verdoppelt. Die andere meldet einen Rückgang. Beides kann stimmen – und warum, ist das Nützlichste, was ein Instandhaltungsleiter vor jeder Unterschrift über diese Kategorie wissen sollte.
Dieser Beitrag behandelt den Unterschied zwischen zeitbasierter, zustandsorientierter und vorausschauender Instandhaltung; warum vieles, was als „vorausschauend“ verkauft wird, in Wahrheit die mittlere ist; und wie Sie die wenigen Maschinen wählen, an denen sich echte Vorhersage bezahlt macht.
Industrielle Realität
Ein typisches Pilotprojekt: Es wird an der wichtigsten Maschine des Werks aufgesetzt. Das liegt nahe – ihr Stillstand kostet am meisten, also wäre ihre Vorhersage am meisten wert. Sensoren kommen dran, Daten fließen, ein Modell wird trainiert, ein Dashboard zeigt einen grünen Gesundheitswert.
Anderthalb Jahre später ist der Wert noch immer grün, und das Projekt wird still abgewickelt. Nichts ist schiefgegangen, und genau das ist das Problem. Die Maschine fiel nicht aus, also sagte das Modell nie einen Ausfall vorher, also kann niemand zeigen, was das Projekt eingespart hat.
Sie fiel nicht aus, weil sie die wichtigste Maschine des Werks ist. Sie hat das kürzeste Wartungsintervall, den erfahrensten Techniker, die Ersatzteile im Regal und den Bediener, der ein verändertes Geräusch vor jedem Sensor bemerkt. Die Anlage mit der meisten Aufmerksamkeit hat die wenigsten Ausfälle, aus denen sich lernen ließe. Der Pilot stand genau dort, wo eine Vorhersage am wenigsten hinzufügen konnte.
Unterdessen fällt eine Kühlmittelpumpe an einer unauffälligen Linie alle paar Monate aus, meist am Wochenende, und wird erst an der Ausschussquote vom Montag bemerkt.
Das ist keine Geschichte über ein schlechtes Modell, sondern darüber, was ein Modell braucht und wo es das vorfindet.
Warum das Problem strukturell ist
Drei Strategien, die im Englischen zu einer verschwimmen
Die deutsche Instandhaltungspraxis hält diese Dinge sprachlich auseinander. DIN 31051 gliedert die Instandhaltung in vier Grundmaßnahmen – Wartung, Inspektion, Instandsetzung und Verbesserung –, und die Praxis benennt die Strategien getrennt: zeitbasierte, zustandsorientierte und vorausschauende Instandhaltung. Im Englischen werden die letzten beiden routinemäßig unter einem Namen verkauft.
- Zeitbasiert (präventiv): Tausch oder Wartung nach Kalender oder Zähler. Nach einer festen Zahl von Betriebsstunden, jedes Quartal, nach einer festen Zahl von Zyklen. Einfach, planbar und blind für den tatsächlichen Zustand des Bauteils.
- Zustandsorientiert: Etwas messen, das sich mit dem Verschleiß des Bauteils ändert – Schwingung, Temperatur, Stromaufnahme, Druck, Partikelzahl – und handeln, wenn es eine selbst gesetzte Grenze überschreitet. Kein Modell nötig. Ein Grenzwert und ein Mensch, der darauf reagiert.
- Vorausschauend: Prognostizieren, wann das Bauteil seine Grenze erreicht. Die einfachste Form schreibt den Signaltrend fort. Ein Modell, trainiert daran, wie vergleichbare Bauteile verschlissen und ausgefallen sind, ist die Form, die eine dokumentierte Ausfallhistorie braucht – und die am häufigsten verkaufte.
Viele Erfolgsgeschichten der Kategorie sind bei näherem Hinsehen zustandsorientierte Instandhaltung mit bewusst gesetzten Grenzwerten. Sie vorausschauend zu nennen, ist eine Marketingentscheidung, keine technische.
Die meisten Ausfälle halten sich nicht an den Kalender
Die Einwände gegen reine Kalenderwartung sind älter als jede Software auf diesem Markt. 1978 veröffentlichten F. Stanley Nowlan und Howard Heap für das US-Verteidigungsministerium ihre Studie über Bauteile ziviler Flugzeuge, den Bericht, der die zuverlässigkeitsorientierte Instandhaltung begründete. Sie trugen die Ausfallwahrscheinlichkeit über dem Alter auf und fanden, dass nur eine kleine Minderheit der untersuchten Teile eine Verschleißzone zeigte, in der eine Altersgrenze hilft. Rund 89 Prozent zeigten überhaupt keine. Bei diesen senkte planmäßiger Tausch die Ausfälle nicht, und zu früher Tausch konnte die Ausfälle hinzufügen, die ein frisch eingebautes Bauteil mit sich bringt.
Flugzeuge sind keine Werkzeugmaschinen, und die genauen Anteile lassen sich nicht auf eine Fabrik übertragen. Das Prinzip schon: Ein festes Intervall hilft nur Bauteilen, die vorhersehbar altern. Für alles andere rät der Kalender.
Vorhersage braucht Ausfälle, und Werke beheben Ausfälle, ohne sie zu dokumentieren
Ein Vorhersagemodell lernt den Unterschied zwischen einer gesunden und einer ausfallgefährdeten Maschine an Beispielen für beides. Gesunde Daten gibt es reichlich. Ausfalldaten sind naturgemäß selten, weil ein gut geführtes Werk Ausfälle verhindert und die eintretenden schnell behebt.
Schlimmer: Instandsetzungen werden selten in einer Form dokumentiert, die ein Modell nutzen kann. Ein Stillstandseintrag sagt, dass die Maschine vier Stunden stand. Selten steht darin, welches Bauteil wie ausfiel und wie die Signale in den Wochen davor aussahen. Zehn Jahre Sensordaten ohne gekennzeichnete Ausfälle sind kein Trainingsdatensatz für ein Ausfallmodell. Keine Modellierungstechnik erzeugt die Beispiele, die das Werk nie erfasst hat.
Eine Warnung ist nur etwas wert, wenn jemand handeln kann
Eine Vorhersage sechs Wochen im Voraus nützt nur, wenn das Ersatzteil in sechs Wochen verfügbar ist, der Stillstand geplant werden kann und jemand eingeteilt ist, ihn zu planen. Dauert die Lieferung länger als der Vorlauf der Warnung, oder landet die Warnung in einem Postfach, für das niemand zuständig ist, war die Vorhersage richtig, und der Ausfall tritt trotzdem ein.
Warum gerade jetzt
Der Markt sendet widersprüchliche Signale – der Anlass für diesen Beitrag.
Im Mai 2026 meldete eine Umfrage im Auftrag eines Messgeräteherstellers unter rund 600 leitenden Entscheidern und Instandhaltungsfachleuten aus vier Fertigungsbranchen in Deutschland, Großbritannien und den USA, der Einsatz von Predictive Maintenance habe sich binnen eines Jahres verdoppelt, von 9 auf 18 Prozent. Proaktive Instandhaltung fiel von 55 auf 45 Prozent, reaktive blieb unverändert bei 36 Prozent. Laut derselben Studie hingen rund 78 Prozent der genannten Hindernisse mit Qualifikation zusammen.
Ein Jahr zuvor verzeichnete The 2025 State of Industrial Maintenance, ein Jahresbericht eines Instandhaltungssoftware-Anbieters, beim Einsatz von Predictive Maintenance einen Rückgang von 30 Prozent (2024) auf 27 Prozent (2025) – während 65 Prozent der Instandhaltungsteams erwarteten, binnen zwölf Monaten KI einzuführen, und 71 Prozent die präventive Instandhaltung als ihre Hauptstrategie nannten.
Legen Sie die Ausgangswerte nebeneinander: Die eine Umfrage startete bei 9 Prozent, die andere bei 30 Prozent, bevor sie auf 27 sank. Wie auch immer die Erhebungszeiträume genau liegen – ein etwa dreifacher Abstand im selben Zeitraum heißt: Die Umfragen zählen nicht dasselbe. Beide sind von Unternehmen beauftragt, die an die Instandhaltung verkaufen, und keine veröffentlicht in den hier zitierten Zusammenfassungen ihren genauen Fragewortlaut. Das Wort „vorausschauend“ deckt heute alles ab, vom Schwingungsalarm bis zum Modell für die Restnutzungsdauer, und Umfragen messen, was die Befragten darunter verstehen.
Für Käufer zählt diese Unschärfe mehr als jede Zahl. Schließt die Definition eines Anbieters einen Grenzwertalarm ein, wirkt die Vorführung überzeugend – und der Business Case beruht auf etwas anderem.
Architektur im Detail
Beim Ausfallmodus beginnen, nicht beim Sensor
Die ergiebige Frage ist nicht, welche Sensoren nachzurüsten sind, sondern: Wie fällt diese Maschine tatsächlich aus, und kündigt sich dieser Ausfall an?
Zuverlässigkeitsingenieure nennen das P-F-Intervall: die Zeit zwischen dem Punkt, an dem ein sich anbahnender Ausfall erkennbar wird (P), und dem Funktionsausfall (F). Ein allmählich verschleißendes Lager zeigt wochenlang steigende Schwingung, bevor es sich festfrisst. Eine Sicherung, ein Softwarefehler oder eine Kollision mit einer Vorrichtung liefert nichts. Nur Ausfälle mit nutzbarem P-F-Intervall lassen sich durch Zustandsüberwachung erkennen oder durch ein Modell vorhersagen – und das Intervall muss länger sein als Ihr Inspektionsintervall plus die Lieferzeit des Ersatzteils, sonst kommt die Warnung zu spät. Alles andere braucht eine andere Antwort: Redundanz, ein Ersatzteil im Regal oder Hinnehmen.
Das Signal zum Ausfall passend wählen
Jeder fortschreitende Ausfallmodus hat Signale, die ihn typischerweise zeigen:
- Rotierende Teile – Lager, Spindeln, Getriebe, Pumpen, Lüfter: Schwingung, später im Verschleißverlauf oft auch Temperatur.
- Antriebe und Motoren: Stromaufnahme und ihr Verlauf über einen Zyklus.
- Hydraulik und Pneumatik: Druck, Durchfluss, Leckage, Zykluszeit eines Stellglieds.
- Schmierung und Fluide: Partikelzahl, Verschmutzung, Temperatur.
- Schneidwerkzeuge: Spindellast und die Werkzeugdaten, die die Steuerung ohnehin führt.
Viele Maschinen messen einiges davon schon zum Eigenschutz. Klären Sie vor jedem Sensorkauf, was Steuerung und Antriebe schon bereitstellen. Unser Beitrag über IoT-Sensortypen zeigt, was jede Sensorklasse aussagen kann und was nicht.
Ein Grenzwert mit Zuständigem schlägt ein Modell ohne
Bei den meisten fortschreitenden Ausfallmodi beginnt man am besten mit einem einfachen Aufbau: ein Signal, eine Referenzmessung im nachweislichen Gutzustand, ein Warn- und ein Eingriffsgrenzwert und eine namentlich benannte Person, die die Warnung erhält und entscheidet, was geschieht. Das ist zustandsorientierte Instandhaltung, und sie braucht keinerlei Ausfallhistorie. Wo noch keine gesunde Referenz existiert, sind die Schwingungszonen nach ISO 20816 der übliche allgemeine Ausgangspunkt, bis die maschineneigene Referenz sie ablöst.
Setzen Sie die Grenzwerte bewusst und schreiben Sie sie auf. Prüfen Sie sie nach dem ersten Monat: Ein Grenzwert, der täglich auslöst, ist nach einer Woche stummgeschaltet, und einer, der nie auslöst, schützt nichts.
Wann ein Modell seinen Platz verdient
Ein Modell bringt gegenüber einem Grenzwert erst dann etwas, wenn drei Dinge zutreffen: Das Werk hat viele gleichartige Anlagen, sodass die Ausfälle im Maschinenpark zusammen eine nutzbare Historie ergeben; die Ausfälle wurden mit Modus und Ursache dokumentiert; und die Entscheidung, die das Modell stützt, ist mit einem geschätzten Datum mehr wert als mit einer einfachen Warnung – etwa weil ein Stillstand Wochen im Voraus eingeplant oder ein Ersatzteil bestellt werden muss.
Wo diese Bedingungen gelten, verlangen Sie eine Spanne, keine Zahl. Eine Restnutzungsdauer als Fenster von Wochen, mit angegebener Konfidenz, lässt sich einplanen. Eine einzelne Zahl liegt irgendwann sichtbar daneben, und beim zweiten Mal liest der Planer sie nicht mehr.
Das Muster, das funktioniert
Die Maschinen nach drei Bedingungen wählen, die alle erfüllt sein müssen, nicht allein nach Kritikalität: Die Maschine fällt fortschreitend aus, das Signal wird schon gemessen oder lässt sich günstig ergänzen, und jemand handelt rechtzeitig auf eine Warnung.
Die Ausfallarten aufschreiben, auf die Sie achten wollen und wie sich jeder in den Daten zeigt, bevor irgendetwas installiert wird.
Mit Grenzwerten beginnen, mit einer gesunden Referenz und einem namentlich Zuständigen für jede Warnung.
Ab heute jeden Ausfall sauber dokumentieren: Bauteil, Modus, Ursache und der Zeitpunkt des ersten Signals. Das ist der Trainingsdatensatz, den Sie in zwei Jahren brauchen.
Erfolg als vermiedene oder verkürzte Stillstände messen, verglichen mit dem Vorjahr an denselben Maschinen – nicht als Modellgenauigkeit.
Ein Modell nur dort ergänzen, wo der Grenzwert das Signal bestätigt und der Maschinenpark die Historie geliefert hat. Unser Beitrag darüber, warum KI ohne Kontext scheitert, erklärt, warum das Modell die letzte Schicht ist, nicht die erste.
Warum die meisten Predictive-Maintenance-Projekte nicht skalieren
Der Pilot an der kritischsten Anlage. Sie hat die meiste Redundanz, die meiste Aufmerksamkeit und damit die wenigsten Ausfälle. Das Projekt kann nichts beweisen und wird beendet, weil es nichts bewiesen hat.
Die ungekennzeichnete Historie. Jahre an Daten, aber keine Aufzeichnung, was wann und warum kaputtging. Das Modell hat nichts, woran es den Ausfall lernen könnte, also lernt es den Normalbetrieb und nennt jede ungewöhnliche Woche eine Anomalie.
Alarmmüdigkeit. Grenzwerte, die alles erfassen sollen. Die Instandhaltung erhält Dutzende Warnungen pro Woche, findet die meisten harmlos und schaltet das System stumm. Technisch läuft es weiter, praktisch ist es aus.
Restnutzungsdauer als einzelne Zahl. Ein selbstsicherer Countdown an einer Anlage, deren Ausfallverhalten niemand beschrieben hat. Er liegt so daneben, dass der Planer es sieht, und das Vertrauen kommt nicht zurück.
Die Warnung, für die niemand eingeteilt ist. Die Vorhersage stimmt, trifft an einem Freitag ein, und das Teil hat eine lange Lieferzeit. Der Ausfall kommt pünktlich.
Erfolg als Modellgenauigkeit definiert. An einer Maschine, die selten ausfällt, liegt ein Modell, das immer „gesund“ meldet, fast jeden Tag richtig und erkennt nichts. Genauigkeit ist die falsche Messlatte; vermiedene Stillstände sind die richtige.
Mehrere davon sind die Lücke aus unserem Beitrag über Dashboards: Ein Signal kann stimmen und trotzdem nichts ändern, weil weder eine Person noch ein Prozess darauf gewartet hat.
Governance, Sicherheit und Mitbestimmung
Der Betriebsrat. Zustandsdaten betreffen Maschinen, werden aber zusammen mit Schichtdaten erfasst, und Reaktionszeiten der Instandhaltung lassen sich Personen zuordnen. In Deutschland ist eine technische Einrichtung, die geeignet ist, Verhalten oder Leistung von Beschäftigten zu überwachen, mitbestimmungspflichtig und vor der Einführung mit dem Betriebsrat zu vereinbaren. Betrachtungseinheit bleiben Anlage und Ausfallmodus; zeigen Sie das Datenmodell früh und halten Sie schriftlich fest, wofür die Daten nicht verwendet werden.
Überwachung liest nur. Zustand zu beobachten heißt, Signale zu lesen. Sie erfordert nie, in eine Maschinensteuerung zu schreiben. Legen Sie das vorab fest und erzwingen Sie es an der Verbindung selbst, nicht nur per Richtlinie.
Einordnung ins Netz. Sensoren und Gateways in der Halle sitzen im Steuerungsnetz oder in dessen Nähe. Entscheiden Sie, in welchem Segment sie liegen, wer sie verwaltet und ob sie von außen erreichbar sind. Für die meisten Werke sollte die letzte Antwort Nein lauten.
Ihre Daten, Ihre Historie. Die Ausfallaufzeichnungen, die Sie jetzt beginnen, werden in den nächsten Jahren zum wertvollsten Gut Ihrer Instandhaltung. Sorgen Sie dafür, dass sie Ihnen gehören und exportierbar bleiben, gleich mit welchem Werkzeug erfasst.
Bewertungsrahmen für die Plattformauswahl
- Was meint der Anbieter mit „vorausschauend“? Einen Grenzwertalarm, eine Trendfortschreibung oder ein an Ausfällen trainiertes Modell? Lassen Sie sich zeigen, welches davon sein Referenzergebnis genutzt hat.
- Welche Ausfallhistorie braucht sein Ansatz, und haben Sie diese? Wenn gekennzeichnete Ausfälle nötig sind: wie viele, welchen Modus?
- Können Sie die Grenzwerte selbst setzen und verantworten, und sehen, warum eine Warnung ausgelöst hat?
- Wird die Restnutzungsdauer als Spanne mit ihrer Unsicherheit angegeben, oder als eine Zahl?
- Wohin geht die Warnung, und wie wird die Reaktion dokumentiert? Eine Warnung ohne Arbeitsauftrag ist eine Benachrichtigung, keine Instandhaltung.
- Können Sie Rohsignale und Ausfallaufzeichnungen exportieren, ohne Beratungsprojekt?
Zusammenfassung für die Geschäftsführung
Erstens. „Predictive Maintenance“ steht für drei verschiedene Dinge. Vieles, was unter diesem Namen verkauft wird, ist zustandsorientierte Instandhaltung – ein gemessenes Signal, ein bewusst gesetzter Grenzwert und ein namentlich Zuständiger –, die weder Ausfallhistorie noch Modell braucht.
Zweitens. Echte Vorhersage braucht Ausfallbeispiele, dokumentiert mit ihrer Ursache. Die meisten Werke haben Jahre an Sensordaten und wenige solcher Aufzeichnungen; die Investition mit dem längsten Nutzen ist daher, ab sofort Ausfälle sauber zu dokumentieren.
Drittens. Die richtigen ersten Maschinen sind nicht die kritischsten. Es sind die, die fortschreitend ausfallen, schon gemessen werden und bei denen jemand bereit ist zu handeln. Bewerten Sie das Programm an vermiedenen oder verkürzten Stillständen, nicht an Modellgenauigkeit, und erwarten Sie erste Belege von wenigen Maschinen binnen Monaten, nicht von einer werksweiten Plattform.
Das Fehlermuster, vor dem sich die Geschäftsführung hüten sollte: das Wort zu kaufen. Fragen Sie, was vorhergesagt wird, aus welcher Historie, und wer auf die Antwort hin handelt.
Praktische Umsetzungs-Checkliste
Bevor irgendetwas gekauft wird
- Die zehn Maschinen auflisten, deren Ausfälle im Vorjahr am meisten gekostet haben. Für jede notieren, wie sie ausfiel und ob es eine Vorwarnung gab.
- Kennzeichnen, welche Ausfallmodi fortschreitend und welche plötzlich sind. Nur die fortschreitenden kommen infrage.
- Prüfen, was jede infrage kommende Maschine schon misst – Steuerung, Antriebe, vorhandene Sensoren.
- Zählen, wie viele frühere Ausfälle an diesen Maschinen ein dokumentiertes Bauteil und eine Ursache haben. Liegt die Antwort nahe null, dort beginnen.
Drei Monate an wenigen Maschinen
- Für jeden Ausfallmodus eine gesunde Referenz für ein Signal aufnehmen.
- Einen Warn- und einen Eingriffsgrenzwert setzen und die Person benennen, die jede Warnung erhält.
- Jede Warnung protokollieren und was daraufhin geschah. Die Grenzwerte nach vier Wochen prüfen.
- Jeden Ausfall mit Bauteil, Modus, Ursache und Datum des ersten Signals dokumentieren.
Bevor ausgeweitet oder ein Modell ergänzt wird
- Die Stillstände an diesen Maschinen mit demselben Zeitraum des Vorjahres vergleichen.
- Nur wo sich ein Signal bewährt und der Maschinenpark eine Ausfallhistorie geliefert hat, ein Modell testen – und auf einer Spanne bestehen.
Eine Anmerkung zu unserem Standpunkt
Wir entwickeln Software in diesem Feld. Wir sind also nicht neutral, und es wäre seltsam, etwas anderes zu behaupten. Dieser Beitrag beschreibt bewusst nicht, was unsere Software kann. Alles oben Gesagte lässt sich im kleinen Maßstab beginnen – mit den Signalen, die Ihre Maschinen ohnehin bereitstellen, einem Notizbuch für Ausfallaufzeichnungen und einer Tabellenkalkulation –, und daran sollte man es messen.
Wenn Sie schnell sehen möchten, ob Ihre Maschinendaten dafür taugen: Wir stellen eine kostenlose Selbsteinschätzung bereit – criussoftware.com/res/kits/readiness/. Sie fragt nach einer geschäftlichen E-Mail-Adresse und Ihrer Einwilligung zur Kontaktaufnahme und zeigt ein bewertetes Ergebnis direkt am Bildschirm; mit einer Telefonnummer erhalten Sie den vollständigen Bericht per E-Mail. Sie ist eine Selbsteinschätzung, kein Audit.
Fragen für Ihre nächste Besprechung
- Wie viele dokumentierte Ausfälle mit Ursache – nicht nur einem Stillstandseintrag – haben Sie für die Maschine, an der Sie pilotieren würden?
- Fällt diese Maschine allmählich oder plötzlich aus? Nur eines davon lässt sich früh erkennen.
- Käme eine Warnung sechs Wochen vor einem Ausfall: Ist das Teil in sechs Wochen verfügbar, und wer plant den Stillstand?
- Wie viele Warnungen pro Woche würde Ihre Instandhaltung lesen, bevor sie aufhört, sie zu lesen?
- Messen Sie Erfolg an vermiedenen Stillständen oder an einer Modellgenauigkeit?
- Was müssten Sie ab heute dokumentieren, damit in zwei Jahren echte Vorhersage möglich ist – und tut das jemand?
- Wenn ein Anbieter Ihnen eine Restnutzungsdauer nennt: Welche Spanne gibt er dazu an?
Was am Ende zählt
Die meisten Maschinen fallen nicht nach Plan aus, also kann ein Kalender allein sie nicht am Laufen halten. Die meisten Werke haben nicht die Ausfallhistorie, die eine Vorhersage braucht, also kann es ein Modell allein auch nicht.
Was dazwischen funktioniert, ist unspektakulär: wissen, wie jede Maschine ausfällt, das Signal beobachten, das es zeigt, einen Grenzwert setzen und die Warnung einem Menschen geben, der handelt. Dokumentieren Sie jeden Ausfall so, als würde jemand daraus lernen – denn in zwei Jahren könnte es ein Modell tun.
Der Kalender rät. Die Maschine sagt es Ihnen – wenn jemand zuhört.
Quellen
- Fluke Corporation / Censuswide, Pressemitteilung vom 7. Mai 2026, Fluke Survey Finds Predictive Maintenance Adoption Doubles as Manufacturers Boost Digital Investment – rund 600 leitende Entscheider und Instandhaltungsfachleute aus vier Fertigungsbranchen, Deutschland, Großbritannien und USA; Predictive 9 % auf 18 %, proaktiv 55 % auf 45 %, reaktiv unverändert bei 36 %; qualifikationsbezogene Herausforderungen rund 78 % der genannten Hindernisse. https://www.finanznachrichten.de/nachrichten-2026-05/68425047-fluke-corporation-fluke-survey-finds-predictive-maintenance-adoption-doubles-as-manufacturers-boost-digital-investment-399.htm (abgerufen am 2026-10-12)
- The Manufacturer, 7. Mai 2026, Auswertung derselben Fluke-Umfrage für Großbritannien. https://www.themanufacturer.com/articles/fluke-survey-finds-predictive-maintenance-adoption-doubles-as-uk-manufacturers-boost-digital-investment/ (abgerufen am 2026-10-12)
- MaintainX, Maintenance statistics and trends, mit Bezug auf The 2025 State of Industrial Maintenance – Einsatz von Predictive Maintenance 30 % (2024) auf 27 % (2025); 65 % erwarten die Einführung von KI binnen zwölf Monaten; 71 % nennen präventive Instandhaltung als Hauptstrategie. https://www.getmaintainx.com/blog/maintenance-stats-trends-and-insights (abgerufen am 2026-10-12)
- F. Stanley Nowlan und Howard F. Heap, Reliability-Centered Maintenance, United Airlines für das US-Verteidigungsministerium, 1978 (DTIC AD-A066579); Zusammenfassung der sechs Ausfallmuster und des Anteils der Teile ohne Verschleißzone: https://reliamag.com/?p=266257 (abgerufen am 2026-10-12)
- DIN 31051, Grundlagen der Instandhaltung – nur für das Vokabular zitiert.
- ISO 20816, Mechanische Schwingungen – Messung und Bewertung der Schwingungen von Maschinen – zitiert als üblicher allgemeiner Bezug für Schwingungszonen.
Noch keine Kommentare. Seien Sie der Erste.