
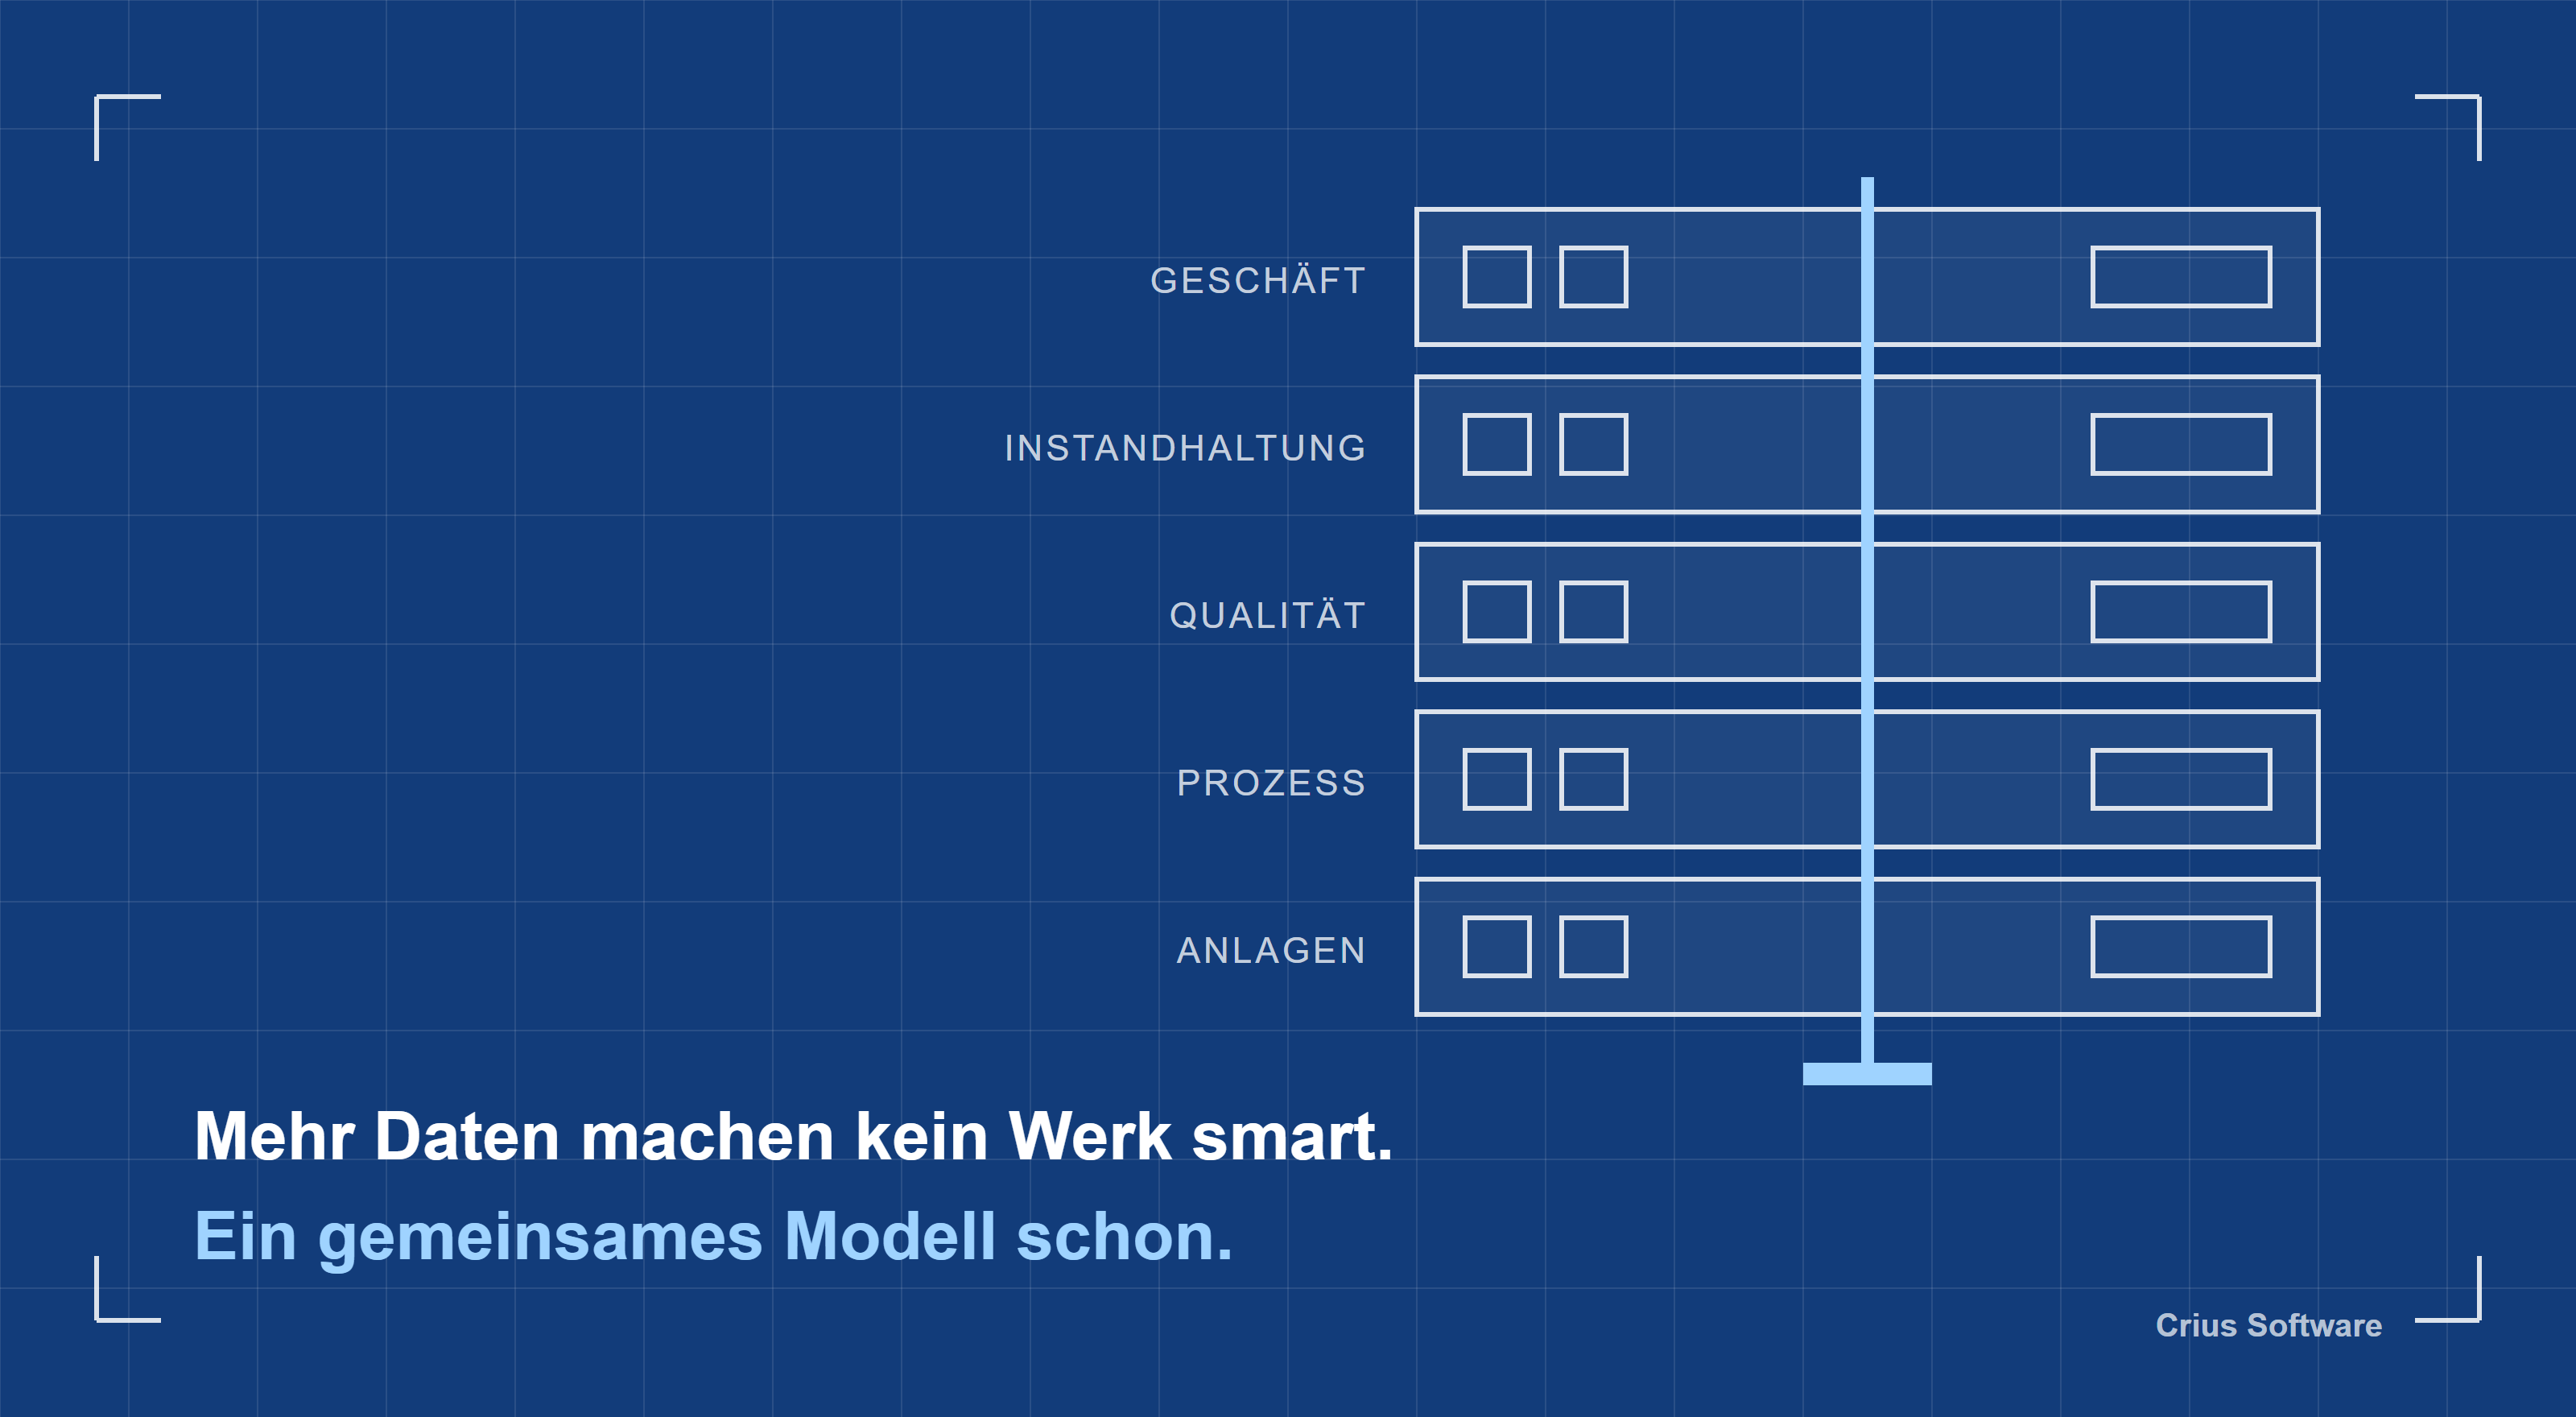
Fertigungsunternehmen fehlt es nicht an Daten. Sie verfügen über SPS-Datenströme, SCADA-Alarme, Historian-Archive, MES-Transaktionen, Qualitätsaufzeichnungen, Instandhaltungs-Arbeitsaufträge, ERP-Stammdaten, Energiedaten und zunehmend Bildverarbeitungs- und KI-Signale. Das Problem ist nicht die Datenerzeugung. Das Problem ist die architektonische Kohärenz.
Ist die industrielle Datenlandschaft fragmentiert, wird jeder neue Anwendungsfall zu einer eigenen Integrationsübung, jede Kennzahl zu einer Streitfrage zwischen Abteilungen, und Analytics-Programme kommen selten über den Pilotstatus hinaus zu spürbarer Unternehmenswirkung.
Ein Smart-Factory-Datenblueprint löst genau das. Er legt fest, wie Daten erfasst, normalisiert, kontextualisiert, verwaltet, gespeichert, ausgewertet und operationalisiert werden. Er macht aus Werkssignalen einen wiederverwendbaren Unternehmenswert — statt einer Sammlung isolierter technischer Datenströme.
Drei Effekte tragen diesen Business Case: ein gemeinsames Entscheidungsmodell, das Betrieb, Engineering, Qualität, Instandhaltung und Führung auf denselben vertrauenswürdigen Kontext stellt, statt auf widersprüchliche lokale Auszüge; sinkende Kosten je Anwendungsfall, sobald das Rückgrat einmal steht — neue Dashboards, Alarme, Optimierungs-Apps und KI-Modelle lassen sich dann schneller und günstiger ausrollen; und eine Transformation, die tatsächlich skaliert — vom Einzelpiloten zu einem wiederholbaren, governance-geführten Rollout über die eigenen Standorte hinweg, mit messbarem betrieblichem Ertrag.
Warum Smart-Factory-Programme ohne Blueprint ins Stocken geraten
Das sichtbare Symptom: zu viele Dashboards, zu wenig Handlung. Die meisten Fertiger verfügen längst über Reporting-Werkzeuge. Trotzdem verlassen sich Teams auf manuellen Abgleich, stillschweigendes Erfahrungswissen und mühsam zusammengestellte Tabellen — weil rohe Maschinendaten allein nicht erklären, was passiert ist, warum es passiert ist, und was als Nächstes zu tun ist.
Die verdeckte Ursache: Architektur, die Fall für Fall gewachsen ist. Werden Konnektivität, Speicherung, Semantik und Zuständigkeit für jede Initiative separat entworfen, entstehen doppelte Pipelines, uneinheitliche Definitionen, brüchige Integrationen — und eine wachsende Angriffsfläche.
Eine Smart Factory sollte als Betriebssystem für industrielle Entscheidungen entworfen werden — nicht als Sammlung voneinander unabhängiger Anwendungen.
| Ohne Blueprint | Mit Blueprint |
|---|---|
| Punktintegrationen für den unmittelbaren Bedarf | Wiederverwendbare Architektur, ausgerichtet auf langfristigen Werks- und Unternehmenswert |
| Kennzahlenstreit zwischen Funktionen und Standorten | Gemeinsame semantische Definitionen und geregelte Datenverträge |
| Analytics-Teams verbringen die meiste Zeit mit Datenbereinigung | Analytics-Teams konzentrieren sich auf Optimierung und Entscheidungsunterstützung |
| Pilotprojekte lassen sich schwer skalieren | Neue Anwendungsfälle erben ein stabiles Fundament |
| OT/IT-Spannungen wachsen mit jeder Integration | Klares Schnittstellenmodell, Sicherheitsgrenzen und Zuständigkeiten |
Der Blueprint: sieben Architekturschichten
Die tragfähigsten industriellen Datenarchitekturen sind nach Verantwortung geschichtet. Jede Schicht löst ein anderes Problem, und die Verwirrung beginnt genau dort, wo Unternehmen alle Verantwortlichkeiten unter einem einzigen Plattform-Etikett zusammenfassen.
1. Quellsysteme
Hier entsteht die operative Realität: SPS, DCS, SCADA, Historians, MES, LIMS, Instandhaltungssysteme, ERP, Energiesysteme, Lagersysteme und zunehmend Sensorik, Kameras und Edge-Geräte. Entscheidend ist, welche Systeme führend sind — also Datenherkunft (system of record) für welche Kategorie —, Rohtelemetrie von transaktionalen Werksereignissen zu trennen und die kritischen Anlagen-, Linien-, Chargen-, Auftrags-, Material- und Qualitätskennungen zu katalogisieren.
2. Konnektivität & Ingestion
Diese Schicht übernimmt die sichere Extraktion und Bewegung von Daten aus OT- und IT-Quellen in das Datenrückgrat — mit Echtzeit- und geplanten Mustern, ohne Steuerungsgrenzen zu umgehen. Protokollbewusste industrielle Konnektoren, standardisierte, beobachtbare Ingestion-Muster sowie ein Entwurf für Pufferung, Wiederholung, Zeitstempelqualität und Edge-Resilienz gehören hierher.
3. Kontext- und Semantikschicht
Die Schicht, die die meisten Programme übersehen. Maschinen-Tags werden erst geschäftstauglich, wenn sie mit Anlagenhierarchien, Produktkontext, Chargen, Schichten, Bedienern, Aufträgen, Materiallosen, Instandhaltungszuständen und Prozessphasen verknüpft sind. Ohne standardisierte Namenskonventionen, Anlagenmodelle und explizite Beziehungen bleiben Kennzahlen über die Zeit instabil.
4. Speicherschicht
Nicht alle industriellen Daten gehören in ein einziges Speichermuster. Hochfrequente Telemetrie, strukturierte Ereignisse, Dokumente, Kontextmodelle und kuratierte Analysedatensätze brauchen unterschiedliche Aufbewahrungs-, Leistungs- und Governance-Behandlung. Hot-, Warm- und Historiendaten müssen ausbalanciert, die Herkunft vom Rohzustand bis zum kuratierten Datensatz erhalten und unkontrollierte Vervielfältigung über Werkzeuge hinweg vermieden werden.
5. Analytics- und Intelligenzschicht
Hier entsteht Fertigungsintelligenz: OEE, Ursachenanalyse von Stillständen, Erkennung von Qualitätsdrift, Energieoptimierung, vorbeugende Instandhaltung, Termintreue, Durchsatzdiagnostik und KI-gestützte Empfehlungen. Diese Schicht sollte auf kontrollierten, freigegebenen Merkmalen aufbauen, nicht auf Ad-hoc-Extrakten, Nachvollziehbarkeit sichtbar halten und Erkenntnisse an verantwortliche Entscheider binden.
6. Operative Handlungsschicht
Eine Datenarchitektur schafft nur Wert, wenn sie Handlung verändert. Alarme sollten Workflows auslösen, Empfehlungen die zuständigen Teams im richtigen Kontext erreichen, und Abweichungsmuster in Planung, Qualität oder Instandhaltung einfließen. Ausgaben gehören in die Arbeitsumgebungen von Bediener, Ingenieur, Planer und Schichtleitung, mit Eskalationslogik entlang realer Schwellenwerte — und gemessen wird die Entscheidungslatenz, nicht die Dashboard-Nutzung.
7. Governance-, Sicherheits- und Lebenszyklusschicht
Diese querliegende Schicht hält den Blueprint sicher, vertrauenswürdig und pflegbar: Zuständigkeit, Zugriffskontrolle, Herkunftsnachweis, Qualitätsregeln, Modellversionierung, Auditierbarkeit, Change Management und Rollout-Standards über Standorte hinweg. Dazu gehören benannte Verantwortliche für Anlagenmodelle, KPI-Definitionen und Schnittstellen sowie rollenbasierter, werksbewusster Zugriff und ein kontrollierter Umgang mit Schemaänderungen.
Das Governance-Modell, das den Blueprint trägt
Dateneigentümerschaft. Jede kritische Domäne braucht eine benannte Zuständigkeit. Anlagenstrukturen, Fertigungsaufträge, Qualitätsereignisse, Stillstandscodes und Instandhaltungsreferenzen dürfen nicht „irgendwie allen gehören“.
Semantische Disziplin. Definiert ein Werk Laufzeit, Mikrostillstand, Ausbeute oder Ausschuss anders als ein anderes, wird der Unternehmensvergleich zur Fiktion. Governance muss Bedeutungen vereinheitlichen, bevor skaliert wird.
Change Control. Neue Tags, umbenannte Anlagen, geänderte Rezepturen und veränderte KPI-Logik brauchen eine kontrollierte Freigabedisziplin — sonst driften Analysen unbemerkt, und das Vertrauen bricht weg.
Governance ist keine Bürokratie. In industriellen Umgebungen ist Governance der Mechanismus, der die Architektur wiederverwendbar, konform und entscheidungstauglich hält, während sich die Werke weiterentwickeln.
Wo Kontext auch Bedienerverhalten einschließt — etwa Schichtmuster oder individuelle Bedienhandlungen als Teil der Kontextschicht —, ist das in deutschen Werken typischerweise keine rein technische Entscheidung. Sie läuft in aller Regel über eine Abstimmung mit dem Betriebsrat, sobald Prozesse oder Arbeitsplätze berührt sind — eine Beobachtung zur betrieblichen Praxis, keine Rechtsauskunft.
ROI-Modell: Wie sich der Blueprint rechnet
Führungsteams finanzieren selten „bessere Daten“ im Abstrakten. Sie finanzieren messbare operative und finanzielle Ergebnisse. Der Smart-Factory-Datenblueprint sollte deshalb als wiederverwendbarer Werttreiber begründet werden, nicht als Technologie-Refresh-Projekt.
Drei Richtungen tragen den Fall: sinkende ungeplante Stillstandszeit durch frühere Erkennung, kontextbezogene Alarme und bessere Priorisierung der Instandhaltung; steigende Erstausbeute, weil die Verknüpfung von Qualität, Prozess, Material und Maschinenzustand Abweichungsmuster früher sichtbar macht und schnellere Korrektur erlaubt; und sinkende Entscheidungslatenz, weil Führung und Werksteams von rückblickendem Reporting zu operativen Entscheidungen im Moment übergehen, mit gemeinsamem Kontext über Funktionen hinweg.
| Hebel | Architekturbeitrag | Relevanz für die Führungsebene |
|---|---|---|
| Durchsatzsteigerung | Verknüpft Maschinenzustand, Prozessleistung und Planungskontext, um Engpässe schneller zu erkennen | Umsatz, Liefertreue, Anlagenauslastung |
| Weniger Qualitätsausschuss | Verbindet Prozessbedingungen, Qualitätsergebnisse und Materialherkunft für frühere Eingriffe | Marge, Kundenleistung, Compliance |
| Instandhaltungseffizienz | Verknüpft Zustandssignale, Auftragshistorie und Kritikalität für bessere Priorisierung | Verfügbarkeit, Arbeitsproduktivität, Ersatzteileinsatz |
| Energieoptimierung | Setzt Verbrauch in Bezug zu Ausstoß, Anlagenzustand und Betriebsmodus statt isolierter Verbrauchsdaten | Kostenkontrolle, Nachhaltigkeit, CO2-Berichterstattung |
| Schnellere Einführung neuer Anwendungsfälle | Stellt wiederverwendbare Ingestion, Semantik und Governance bereit statt eines Neustarts bei null | Transformationsgeschwindigkeit, Capex-Effizienz |
Ein oft unterschätzter Ertrag: die sinkenden Grenzkosten jedes weiteren Anwendungsfalls. Stehen Ingestion, Kontext, Semantik, Governance und Speichermuster einmal, braucht jede neue digitale Initiative weniger Nacharbeit — das senkt die Grenzkosten von Innovation und erhöht das Transformationstempo. In deutschen Mittelstandsunternehmen kommt eine praktische Randbedingung hinzu: Investitionsbudget für solche Vorhaben wird meist einmal jährlich im Rahmen der Jahresplanung freigegeben — ein Business Case, der ausschließlich mit Kennzahlen aus dem laufenden Geschäftsjahr argumentiert, verpasst dieses Fenster leicht.
Fahrplan zur Umsetzung: von der Idee zur skalierbaren Ausführung
- Mit einem Wertstrom beginnen, nicht mit dem ganzen Unternehmen. Eine Linie, einen Werksbereich oder eine Produktfamilie wählen, in der Stillstand, Qualität, Durchsatz oder Energieleistung bereits finanziell zählen. Ziel ist der architektonische Nachweis mit operativem Wert — keine abstrakte Technologievalidierung.
- Den Datenvertrag definieren, bevor Pipelines gebaut werden. Kennungen, Zeitstempel, Zustandsmodelle, Ereignislogik, Qualitätsregeln und KPI-Definitionen klären, bevor die große Integrationsarbeit beginnt — das verhindert teure Nacharbeit später.
- Kontext als eigenständige Fähigkeit aufbauen. Nicht bei Konnektivität stehen bleiben: Telemetrie mit Aufträgen, Chargen, Material, Schicht, Anlagenhierarchie, Qualitätsdisposition und Instandhaltungshistorie verbinden, damit die Daten auch außerhalb des Engineering-Teams nutzbar sind.
- Erkenntnis in Workflow operationalisieren. Alarme, Ausnahmen, Empfehlungen und Kennzahlen in die Umgebungen bringen, in denen Teams bereits arbeiten. Architektur schafft nur Wert, wenn sie Entscheidungen und Reaktionsverhalten tatsächlich verändert.
- Mit Standards skalieren, nicht mit Duplikation. Sobald der erste Rollout Wert bewiesen hat, über Referenzmodelle, wiederverwendbare Ingestion-Muster, Governance-Vorlagen und Standort-Onboarding-Playbooks replizieren — statt jedes Mal neu zu bauen.
Fragen, die die Unternehmensleitung vor der Freigabe stellen sollte
Ein Blueprint ist kein Selbstzweck. Bevor Budget freigegeben wird, lohnt sich eine Trennung zwischen strategischen Fragen — die den Business Case prüfen — und architektonischen Fragen, die prüfen, ob das technische Fundament tatsächlich trägt, was der Business Case verspricht.
Strategische Fragen
- Welche operativen Ergebnisse rechtfertigen die Investition zuerst?
- Welche Werke oder Wertströme sollten das Referenzmodell werden?
- Wie definieren wir Erfolg jenseits der Dashboard-Nutzung?
- Welche Datendomänen sind wirklich unternehmenskritisch?
Architektonische Fragen
- Wo wird Kontext erzeugt und gepflegt?
- Wie werden OT- und IT-Zuständigkeiten getrennt und koordiniert?
- Welches Governance-Gremium verantwortet semantische Konsistenz über Standorte hinweg?
- Wie konsumieren neue KI-Anwendungsfälle vertrauenswürdige industrielle Daten, ohne jedes Mal eine Sonderlösung zu brauchen?
Die Smart Factory entsteht nicht dadurch, dass mehr Maschinendaten gesammelt werden. Sie entsteht durch eine verlässliche Architektur, die industrielle Signale in operativen Kontext, geprüfte Erkenntnis und wiederholbare Handlung verwandelt. Fertiger, die das Datenrückgrat als strategische Infrastruktur behandeln, kommen bei Analytics, KI, Qualität, Instandhaltung, Energie und der Standardisierung über die eigenen Standorte hinweg schneller voran. Fertiger, die weiter Einzelintegrationen bauen, zahlen für dasselbe Grundproblem immer wieder von Neuem.
Erweiterter Volltext — Board-Report-Format
Zusammenfassung für die Geschäftsleitung
Executive-Perspektive: Smart-Factory-Transformation gelingt, wenn industrielle Daten aufhören, sich wie eine Sammlung unverbundener technischer Nebenprodukte zu verhalten, und stattdessen wie ein gemanagter Betriebswert behandelt werden. Die zentrale Frage ist nicht, ob Werke Daten erzeugen können — das tun sie längst. Die Frage ist, ob Fertiger diese Daten in ein verlässliches, kontextualisiertes, geregeltes Fundament verwandeln können, das Echtzeitbetrieb, funktionsübergreifende Transparenz und skalierbare KI-Einführung trägt. Dieser Bericht beschreibt, wie das diszipliniert gelingt.
1. Das eigentliche Problem ist Fragmentierung, nicht fehlende Instrumentierung
Viele Fertiger starten die digitale Transformation mit einer falschen Annahme: dass fehlende Daten die Hauptbarriere seien. Tatsächlich liegt die größere Barriere darin, dass vorhandene Daten über inkompatible Systeme verstreut, unter unterschiedlichen Eigentümerschaftsmodellen erfasst und nach uneinheitlichen betrieblichen Definitionen interpretiert werden. SPS liefern Steuerungssignale, SCADA und Historians erfassen Prozessverhalten, MES verfolgt die Ausführung, Qualitätssysteme erfassen Prüfergebnisse, Instandhaltungssysteme halten Auftragshistorie, ERP trägt Stammdaten, Bedarfssignale und Kostenkontext. Jede Quelle ist für sich nützlich, aber keine liefert allein das vollständige Bild. Deshalb werden viele Werke datenreich und zugleich erkenntnisarm: Teams sehen Alarme, Trends und Berichte — und tun sich trotzdem schwer, die entscheidenden Fragen zu beantworten: Was ist tatsächlich passiert? Unter welchem Betriebskontext? Welche geschäftlichen Größen waren betroffen? Welche Handlung sollte folgen? Wer ist funktionsübergreifend verantwortlich?
2. Warum ein Blueprint zählt
Ein Smart-Factory-Datenblueprint gibt darauf eine strukturierte Antwort. Er legt fest, wie Informationen aus operativen und Unternehmenssystemen in eine gemeinsame Architektur fließen — wo standardisiert, wo Kontext hinzugefügt, wo Vertrauen hergestellt, wo Zugriff geregelt und wo Erkenntnis in Handlung übersetzt wird. Ohne diesen Blueprint wird jeder neue Anwendungsfall zur Neuerfindung: ein Team baut eine Pipeline für Stillstandsberichte, ein anderes einen separaten Extrakt für Qualitäts-Dashboards, ein drittes ein eigenes Modell für vorbeugende Instandhaltung. Mit der Zeit wird die Architektur teurer, weniger steuerbar und schwerer zu skalieren. Strategisch verwandelt der Blueprint digitale Transformation von einem Projektportfolio in eine industrielle Fähigkeit — die Grundlage, um Wert wiederholt statt punktuell zu schaffen.
3. Kontext ist die wichtigste Architekturentscheidung
Die Kontextschicht ist das Herzstück des Blueprints: Hier wird Telemetrie erklärbar. Maschinenwerte werden auf Anlagenhierarchien gemappt, Prozesssignale mit Aufträgen, Rezepturen, Chargen, Schichten und Betriebsmodi verknüpft, Qualitätsergebnisse mit den genauen Prozessbedingungen verbunden, unter denen sie entstanden. Ohne diese Schicht entstehen zwar weiterhin Dashboards — aber sie bleiben beschreibend statt operativ: Sie zeigen, was sich bewegt hat, nicht warum. Für Fertiger, die KI einführen wollen, wiegt das doppelt: KI-Modelle brauchen konsistente, gekennzeichnete, kontextreiche Daten. Ist die semantische Struktur schwach, wird Modellentwicklung zur wiederkehrenden Aufräumarbeit — jeder Anwendungsfall wird teurer, das Vertrauen in die Ausgaben sinkt.
4. Speicherung soll der Workload folgen
Ein verbreiteter Fehler ist die Annahme, alle industriellen Daten gehörten in ein einziges Speichermuster. Hochfrequente Telemetrie hat andere Anforderungen an Leistung und Aufbewahrung als Ereignisströme, strukturierte Transaktionen, Dokumente, semantische Modelle und kuratierte Feature-Sets. Die Speicherschicht sollte sich deshalb an Zugriffsmustern, Datenkritikalität, Latenzanforderungen und Governance-Regeln orientieren, nicht an Werkzeug-Bequemlichkeit. Ein ausgereifter Blueprint erhält die Herkunft vom Rohzustand bis zum kuratierten, entscheidungstauglichen Datensatz und erlaubt kein unkontrolliertes Kopieren zwischen Werkzeugen ohne Zuständigkeit — diese Nachvollziehbarkeit ist die Grundlage für Auditierbarkeit, Reproduzierbarkeit und funktionsübergreifendes Vertrauen, besonders dort, wo operative Entscheidungen Qualitäts-, Sicherheits- oder Kundenkonsequenzen haben.
5. Analytics soll bei Entscheidungen beginnen, nicht bei Dashboards
Die Analytics- und Intelligenzschicht ist dort, wo die meisten Transformationsprogramme sichtbaren Wert erwarten — zu Recht, aber nur, wenn die Schicht auf Entscheidungen ausgelegt ist und nicht auf reine Darstellung. Eine Smart Factory sollte abnormales Verhalten erkennen, wahrscheinliche Ursachen erklären, Handlungspfade empfehlen und diese in echte Workflows einspeisen können — von OEE-Diagnostik über Stillstands-Ursachenanalyse und Ausbeuteverlust bis zu Instandhaltungspriorisierung, Engpassüberwachung, Energieoptimierung und KI-gestützter Szenarioauswertung. Die Reife dieser Schicht hängt stark von der Qualität der vorgelagerten Architektur ab: Kommen Daten spät, uneinheitlich gekennzeichnet oder ohne stabile Definitionen an, wird Analytics zur nachträglichen Rekonstruktion einer Geschichte statt zur Beschleunigung der Leistung. Der Blueprint stellt deshalb sicher, dass Analytics-Konsumenten geprüfte, freigegebene Datenprodukte erben, keine instabilen Extrakte.
6. Operative Handlung ist, wo der Wert entsteht
Viele digitale Programme bleiben unbeabsichtigt bei der Erkenntnis stehen: Sie erzeugen Berichte, Kennzeichnungen oder Vorhersagen, verbinden sie aber nicht mit Werks-Workflows. Der Blueprint muss explizit festlegen, wie Erkenntnis zu Handlung wird — welche Alarme an Bediener gehen, welche an Schichtleitung eskalieren, welche Instandhaltungsaufträge auslösen, welche an die Prozessplanung gehen, welche Bedingungen einen Eingriff rechtfertigen und welche Ergebnisse anschließend gemessen werden. Dieses Handlungsmodell verkürzt die Entscheidungslatenz — es macht aus einer Beobachtungsschicht ein Leistungssystem.
7. Governance ist der Skalierungsmechanismus
Governance wird häufig als Overhead missverstanden. Tatsächlich ist sie der Mechanismus, der einen Smart-Factory-Blueprint über die Zeit kohärent hält. Industrielle Umgebungen verändern sich fortlaufend: neue Maschinen kommen hinzu, Anlagennamen ändern sich, Produktmix entwickelt sich weiter, Werke wachsen, Standorte legen Regeln unterschiedlich aus. Ohne Governance wächst die architektonische Entropie schnell. Governance muss Eigentümerschaft, Zugriff, Semantik, Herkunft, Change Management und Lebenszyklus-Kontrollen abdecken, mit benannter Verantwortung für Anlagenhierarchien, KPI-Definitionen, Stammdatenharmonisierung, Schnittstellenänderungen und Rollout-Standards. Das gilt besonders in Unternehmen mit mehreren Standorten, wo lokale Pragmatik leise die unternehmensweite Vergleichbarkeit untergräbt — hier meint das ausdrücklich die eigenen Werke eines Unternehmens, nicht einen Vergleich über verschiedene Kundenorganisationen hinweg. Gute Governance beschleunigt Skalierung, weil sie die Kosten der Neuinterpretation senkt: Stehen Definitionen, Muster und Standards einmal fest, wird die Anbindung weiterer Werke deutlich einfacher.
8. Wie der Blueprint finanziellen Wert schafft
Führungsteams brauchen einen klaren Investment Case, und die stärksten ROI-Fälle stützen sich auf messbare operative Hebel: geringere ungeplante Stillstandszeit durch bessere Zustandserkennung und Instandhaltungspriorisierung, höhere Ausbeute durch frühere Verknüpfung von Prozesszuständen und Materialbedingungen mit Qualitätsergebnissen, höherer Durchsatz durch Echtzeit-Sichtbarkeit von Engpässen und abgestimmteres Handeln zwischen Planung, Betrieb und Engineering, weniger Energieverschwendung durch Verbrauch, der in Bezug zu Ausstoß und Betriebsmodus sichtbar wird statt in isolierten Verbrauchsberichten zu verschwinden. Häufig unterschätzt: die sinkenden Grenzkosten künftiger Anwendungsfälle — stehen Ingestion, Kontext, Semantik, Governance und Speichermuster einmal, braucht jede neue digitale Initiative weniger Nacharbeit.
9. Ein praktischer Fahrplan zur Umsetzung
Der empfohlene Rollout-Pfad ist diszipliniert und phasenweise: mit einem Wertstrom oder Werksbereich beginnen, in dem wirtschaftliche Wirkung sichtbar ist und Führungsaufmerksamkeit besteht — nicht das gesamte Unternehmen auf einmal digitalisieren. Den Datenvertrag definieren, bevor die schwere Integrationsarbeit beginnt: Kennungen, Zeitstempel, Ereignislogik, Zustandsmodelle, KPI-Regeln. Kontextualisierung als eigenständige Fähigkeit aufbauen, nicht als spätere Ergänzung behandeln. Sicherstellen, dass Erkenntnisse in Workflows operationalisiert werden, statt als eigenständige Berichte liegen zu bleiben. Sobald der erste Rollout Wert bewiesen hat, über Standards, Referenzmodelle und Playbooks skalieren — Replikation bedeutet nicht Duplikation; das Ziel ist ein Referenz-Blueprint, der sich mit kontrollierter Variation konsistent auf weitere Standorte übertragen lässt, nicht ein Nachbau Werk für Werk.
10. Was Führungskräfte im Kopf behalten sollten
Die Smart Factory ist keine Sensorstrategie. Sie ist kein Dashboard-Programm. Sie ist kein Data Lake für sich genommen. Sie ist eine architektonische Disziplin, die industrielle Entscheidungen im großen Maßstab ermöglicht. Die Fertiger, die hier führend werden, sind jene, die Datenkontext, Governance und operative Integration als strategische Fähigkeiten behandeln — sie sehen schneller Wert aus Analytics, verlässlichere KI-Einführung, stärkere funktionsübergreifende Abstimmung und mehr Resilienz, wenn sich Werke und Produkte verändern. Wer diese Denkweise nicht übernimmt, finanziert weiter isolierte Anwendungsfälle, die Symptome lösen, während das Grundproblem bestehen bleibt — Komplexität häuft sich an, ohne dass sich der Wert vermehrt. Der Smart-Factory-Datenblueprint ist der Mechanismus, der dieses Muster umkehrt.
Schlussfolgerung: Eine skalierbare Smart Factory beginnt mit einer skalierbaren industriellen Datenarchitektur. Ist dieses Fundament bewusst entworfen, wird jede weitere Optimierung glaubwürdiger, steuerbarer und wirtschaftlich wertvoller.
Daniel aktualisiert am 19 Nov 2025, 08:15AM
This is one of the better explanations I’ve seen of why manufacturers need to separate data transport, context, and consumption. Too many projects still assume a dashboard equals a data strategy.Kavya aktualisiert am 19 Nov 2025, 10:02AM
Agreed. The context layer stood out to me. We have plenty of machine data already, but very little production context around order, operator, material lot, or shift. That is exactly why analytics adoption has been weak.Jonas aktualisiert am 19 Nov 2025, 01:28PM
The phased rollout section is practical. Starting with one value stream and proving downtime, scrap, and OEE improvement is far more realistic than trying to “digitize the whole factory” in one budget cycle.Priya aktualisiert am 20 Nov 2025, 09:11AM
The point about historian data not being enough for enterprise-scale optimization is important. We learned that the hard way once quality, maintenance, and ERP data needed to be joined in near real time.Felix aktualisiert am 20 Nov 2025, 11:47AM
Yes, and the governance angle matters just as much. Our pilot worked technically, but failed to scale because no one owned tag standards, asset hierarchies, or KPI definitions across sites.Hannah aktualisiert am 20 Nov 2025, 03:36PM
The architecture layering is clear. I especially liked the distinction between ingestion, contextualization, storage, analytics, and operational action. Many vendors compress all of that into one box and create confusion.Arjun aktualisiert am 21 Nov 2025, 08:54AM
Would be great to see more manufacturers treat event models and semantic modeling as first-class design decisions. Without them, AI use cases become expensive clean-up exercises.Lena aktualisiert am 21 Nov 2025, 12:20PM
Exactly. The article makes the right point: AI readiness is not a tool purchase, it is a data discipline problem first.Tobias aktualisiert am 21 Nov 2025, 04:05PM
The security section is balanced. Plant leaders often worry that more connectivity automatically means more risk, but a structured architecture with segmentation, identity, and monitored interfaces is actually safer than ad hoc integrations.Meera aktualisiert am 22 Nov 2025, 09:32AM
The ROI framing is useful for leadership discussions. Boards rarely approve “data modernization” on abstraction alone, but they will support a roadmap tied to throughput, energy, maintenance, and quality economics.Oliver aktualisiert am 22 Nov 2025, 02:18PM
I also appreciated that the article did not oversell full autonomy. Most factories still need a strong human-in-the-loop model, especially in quality, maintenance planning, and exception handling.Nikhil aktualisiert am 23 Nov 2025, 10:06AM
The implementation roadmap is close to what we are doing now: standardize the data contract, build one governed pipeline, contextualize the assets, and only then expand to multi-site analytics.Greta aktualisiert am 23 Nov 2025, 01:41PM
That sequence matters. We skipped standardization at first and spent months reconciling naming differences between otherwise identical production lines.Samuel aktualisiert am 24 Nov 2025, 08:27AM
Strong article. The core message is right: the smart factory is not built on isolated use cases; it is built on a reusable industrial data foundation that makes new use cases cheaper and faster over time.